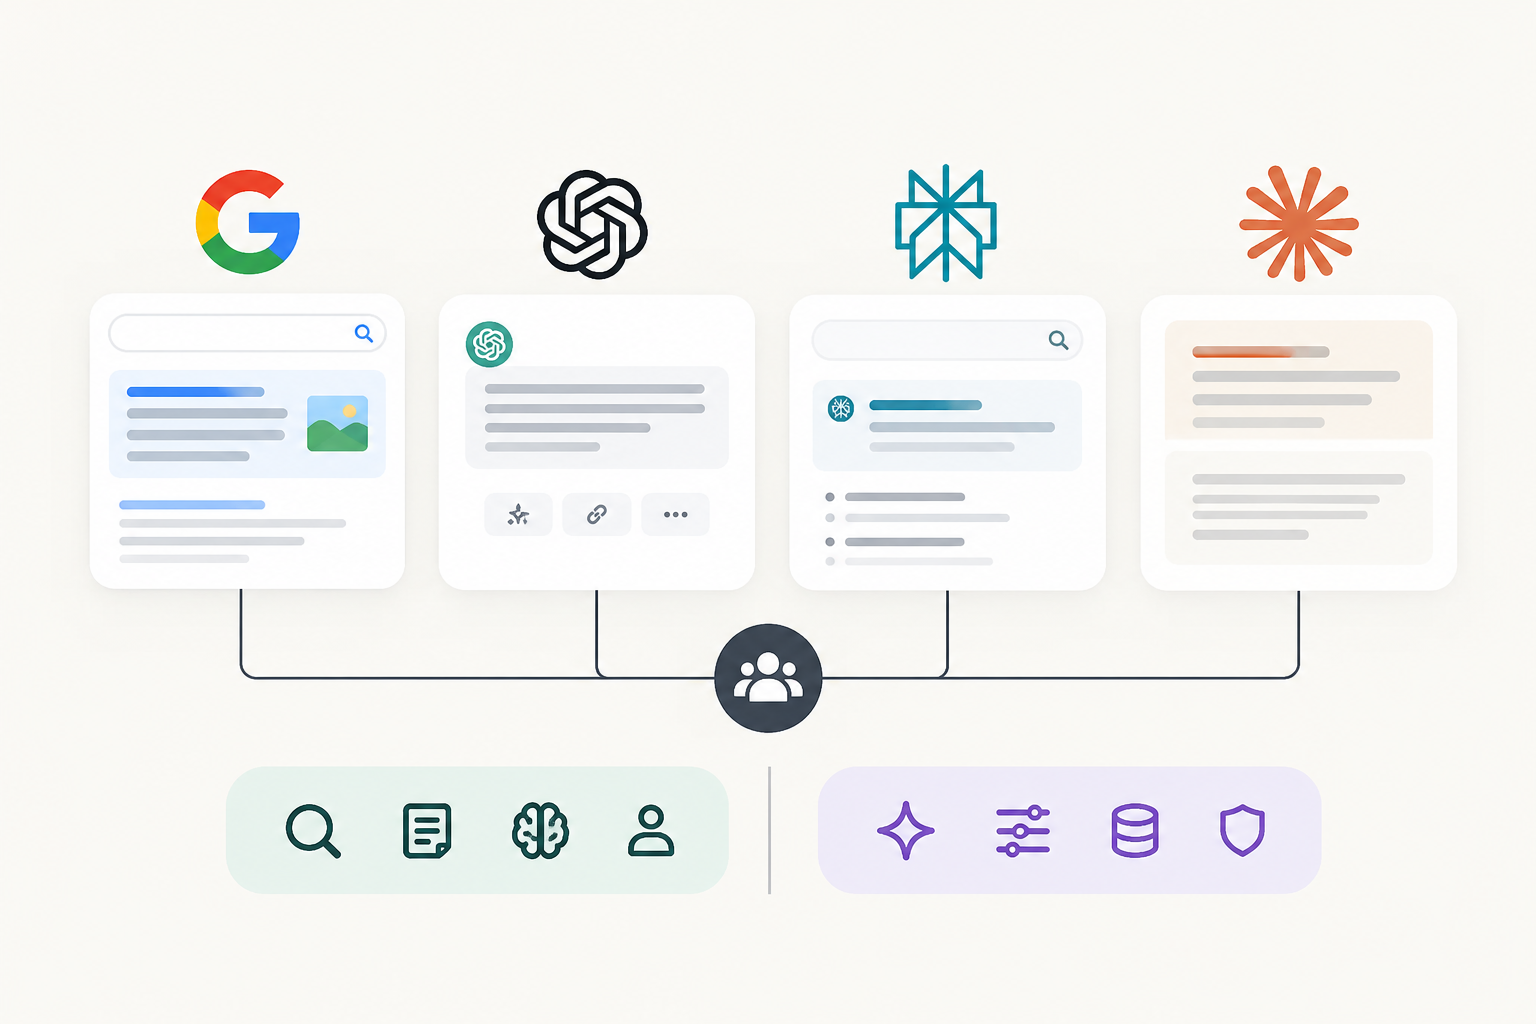
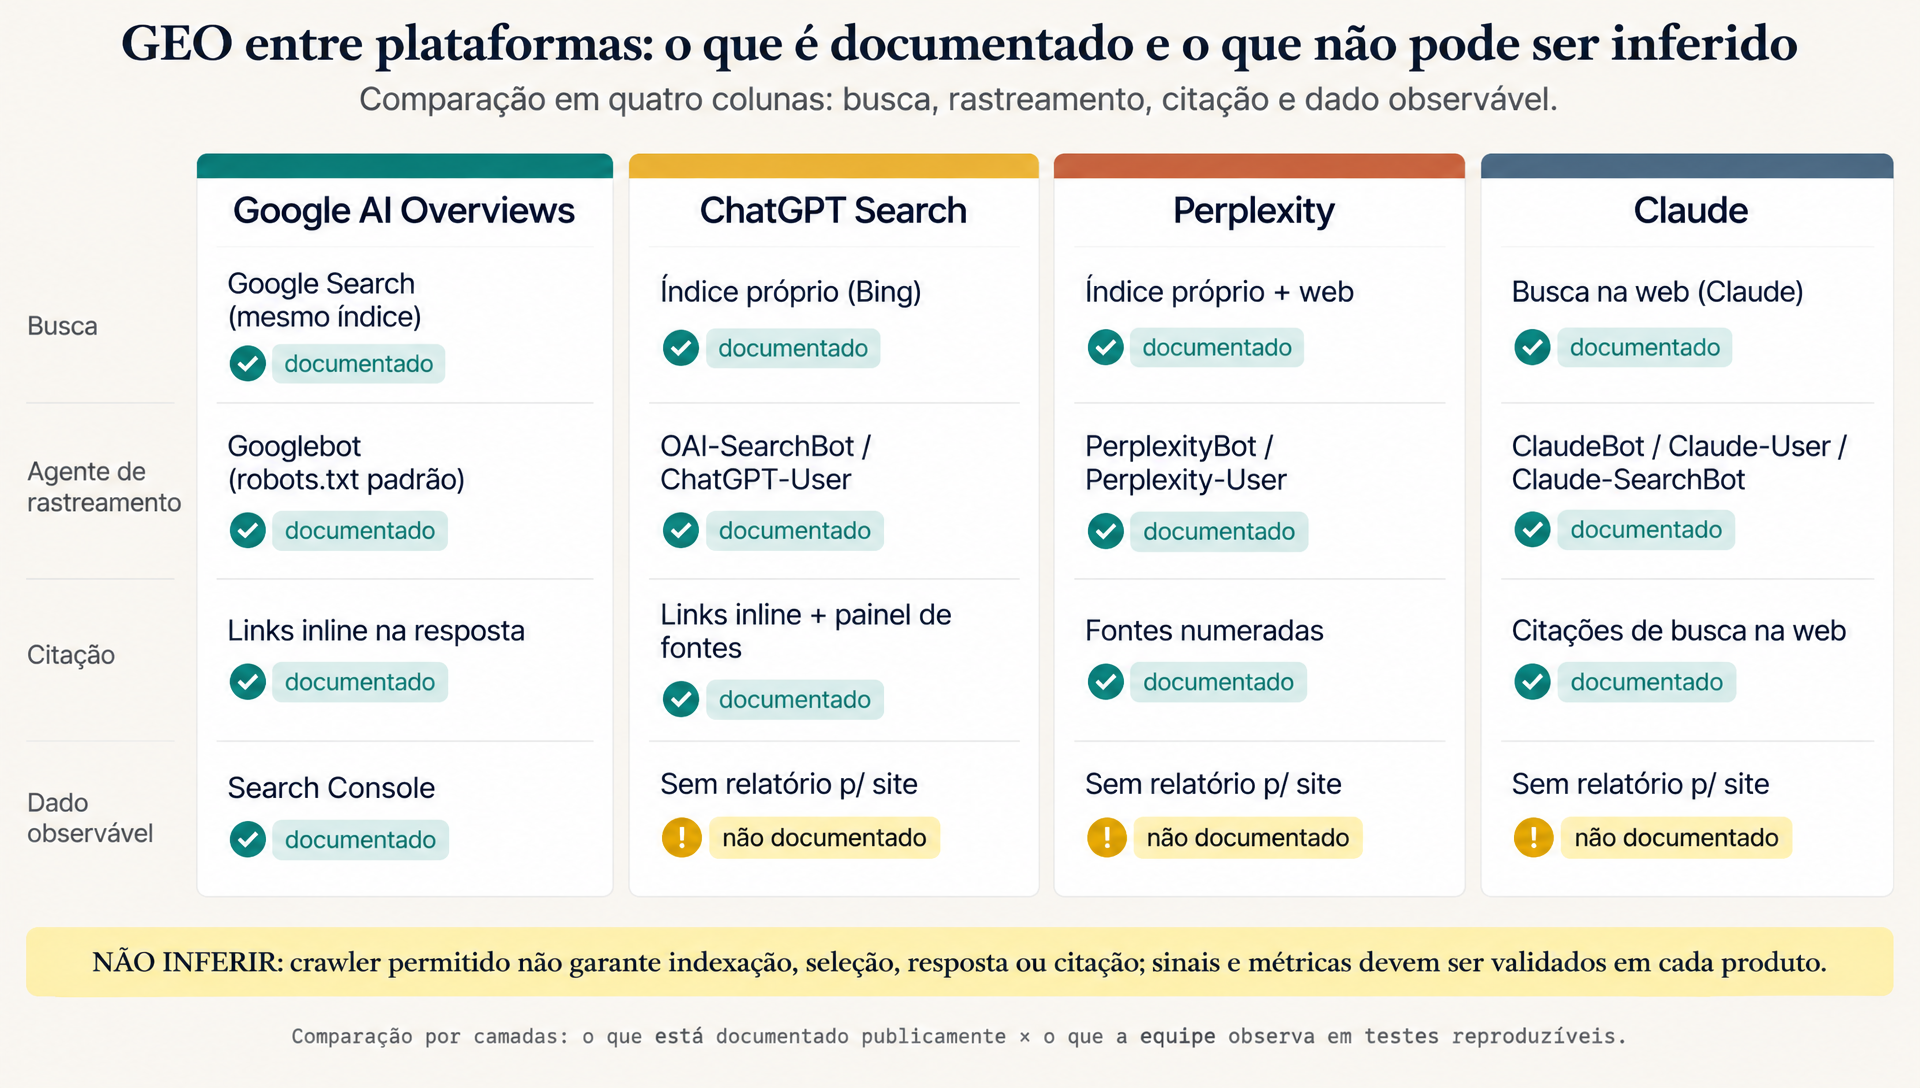
Colocar Google AI Overviews, ChatGPT Search, Perplexity e Claude dentro da mesma coluna de um relatório como se operassem sob um único algoritmo é o caminho mais rápido para distorcer diagnósticos de GEO. Embora os quatro sistemas sintetizem respostas com apoio da web, cada um utiliza agentes de rastreamento, regras de indexação, formatos de citação e controles técnicos distintos.
Construir uma presença sólida exige separar o que é base compartilhada de engenharia (acessibilidade HTTP, clareza semântica e dados verificáveis) do que varia entre os fornecedores. Neste comparativo técnico, analiso o funcionamento documentado de cada plataforma para que sua operação saiba exatamente o que auditar em cada ambiente.
A Base Compartilhada de Engenharia e Conteúdo no GEO
O ponto comum mais seguro é preparar páginas úteis para pessoas, acessíveis na web e sustentadas por informação verificável. Essa é uma base de publicação, não uma fórmula compartilhada de ranqueamento ou garantia de que qualquer produto vai selecionar a página.
No Google, a documentação orienta a continuar aplicando fundamentos de SEO, manter o conteúdo importante em forma textual, usar links internos e garantir que dados estruturados correspondam ao conteúdo visível. A mesma documentação diz que não existem requisitos especiais para AI Overviews ou AI Mode e que atender aos critérios técnicos não garante exibição. Eu não extrapolo essa política para as outras plataformas.
Para qualquer operação, eu começaria por quatro perguntas: a página está acessível? A resposta atende à tarefa do usuário? As afirmações podem ser verificadas? A organização consegue atualizar o conteúdo quando os fatos mudam? Essas perguntas orientam uma auditoria consistente sem pressupor que todos os produtos compartilham os mesmos algoritmos.
| Base de trabalho | O que fazer | O que não se deve concluir |
|---|---|---|
| Acesso | Revisar rastreamento, resposta HTTP, WAF e disponibilidade do conteúdo | Que permitir um bot garanta inclusão ou citação |
| Clareza | Explicar a resposta, escopo, condições e limites | Que todas as plataformas prefiram o mesmo formato textual |
| Evidência | Citar fontes e registrar autoria, método e data quando relevantes | Que uma menção ou link assegure recomendação em uma resposta |
| Atualização | Revisar informação conforme sua validade e fonte de verdade | Que alterar a data sem atualização torne o conteúdo atual |
| Mensuração | Salvar plataforma, consulta, contexto, data e fontes observadas | Que impressões, visitas e citações sejam métricas equivalentes |
A documentação do Google recomenda conteúdo útil e confiável, com informação original e valor para o público, em vez de produção voltada apenas a mecanismos de busca. Eu uso esse princípio como orientação editorial para o site, mas não o descrevo como uma lista de fatores de ranking comum aos quatro produtos.
O guia geral de GEO já publicado no HCE Web apresenta o conceito da disciplina. Este comparativo aprofunda uma pergunta diferente: o que pode ser feito em comum e onde é necessário manter regras específicas por produto.
Google AI Overviews e AI Mode: Integração Direta com o Índice da Busca
AI Overviews é um recurso dentro da Busca Google, não um produto independente com um crawler editorial exclusivo. Para que uma página possa aparecer como link de apoio, ela precisa estar indexada e apta a aparecer na Busca com snippet, sem requisitos adicionais específicos de IA.
O Google documenta que AI Overviews e AI Mode podem usar query fan-out, isto é, pesquisas relacionadas a subtemas e fontes durante a composição da resposta. A documentação também diz que as respostas e links podem variar entre AI Overviews e AI Mode, pois os recursos podem usar modelos e técnicas diferentes. Isso descreve a Busca Google, não um comportamento comprovado de ChatGPT Search, Perplexity ou Claude.
Na prática, eu começo pelo Googlebot, indexação, conteúdo visível e controles de snippet. Se uma URL não está indexada ou não pode aparecer com snippet, revisar apenas o texto para “AI Overview” não resolve a pré-condição. Também evito transformar query fan-out em instrução para publicar uma página para cada subconsulta.
| O que revisar no Google | Evidência possível | Limite de interpretação |
|---|---|---|
| Elegibilidade | Indexação e capacidade de exibir snippet | Elegibilidade não é garantia de inclusão |
| Conteúdo | Texto principal, política de conteúdo e correspondência com dados estruturados | Schema não cria elegibilidade especial para AI Overviews |
| Descoberta | Googlebot, links internos e controles de acesso | Acesso não equivale a seleção pela resposta |
| Desempenho | Search Console e Analytics conforme as dimensões disponíveis | Tráfego agregado não mostra necessariamente todas as citações ou prompts |
Para o contexto editorial específico do Google, consulte o artigo sobre Arquitetura de Conteúdo para AI Overview. O novo pilar de arquitetura de conteúdo para citação por IAs amplia a discussão para intenção, evidência e descoberta sem misturar as políticas de cada produto.
ChatGPT Search: OAI-SearchBot, GPTBot e Recuperação Web
ChatGPT Search pode pesquisar a web quando a pergunta se beneficia de informação atual e pode apresentar citações com links para fontes. A OpenAI documenta um crawler específico para busca, OAI-SearchBot, separado de GPTBot, associado ao rastreamento de conteúdo que pode ser usado no treinamento de modelos.
A distinção importa para SEO técnico. Segundo a documentação da OpenAI, bloquear OAI-SearchBot impede que o site apareça nas respostas de busca do ChatGPT, embora ainda possa aparecer como link de navegação. ChatGPT-User é usado em determinadas ações iniciadas pelo usuário, mas não determina a inclusão nos resultados do Search. A OpenAI também descreve GPTBot como agente separado, e as preferências para cada agente são independentes.
Na operação, eu separaria as diretivas no robots.txt e validaria os registros do servidor, do CDN e do WAF. Não confundiria bloqueio de treinamento com bloqueio de busca nem usaria acessos de ChatGPT-User como prova de que a página está elegível para ChatGPT Search.
| Agente da OpenAI | Finalidade descrita | Implicação prática para a auditoria |
|---|---|---|
| OAI-SearchBot | Descobrir sites para recursos de busca do ChatGPT | Revisar robots.txt, IPs publicados e bloqueios de infraestrutura |
| GPTBot | Rastrear conteúdo que pode contribuir para treinamento de modelos | Tratar como controle separado de busca |
| ChatGPT-User | Acessar páginas em certas ações iniciadas por usuários | Não usar esse agente como indicador de inclusão em Search |
A presença de uma URL citada em uma resposta específica ainda depende do contexto e da seleção feita no produto. Por isso, registro a pergunta, a data e a fonte exibida, em vez de transformar uma captura de tela em prova de participação permanente.
Perplexity: Arquitetura Orientada a Fontes e PerplexityBot
O Perplexity descreve seu produto como uma experiência que interpreta uma pergunta, pesquisa a web e apresenta respostas conversacionais com citações para as fontes originais. A central de ajuda descreve também modos de pesquisa com diferentes níveis de aprofundamento, por isso duas consultas não devem ser tratadas como testes idênticos sem registrar a configuração usada.
A documentação de rastreadores diferencia PerplexityBot, usado para descobrir e ligar sites nos resultados de busca, de Perplexity-User, usado em acessos iniciados por uma pergunta de usuário. A documentação informa que as configurações são independentes e que o Perplexity-User geralmente ignora regras de robots.txt por se tratar de uma busca solicitada pelo usuário.
Essa diferença muda o que eu procuro nos logs. Se há acessos de Perplexity-User, posso concluir que ocorreu uma solicitação de acesso com aquele agente, não que o domínio foi incluído no índice de busca nem que aparecerá citado em todas as respostas. Também verifico os IPs publicados e as regras de WAF para não classificar uma requisição legítima como tráfego automatizado genérico.
| Agente do Perplexity | Finalidade descrita | O que não comprova sozinho |
|---|---|---|
| PerplexityBot | Descoberta e exibição de sites nos resultados do Perplexity | Citação em uma resposta específica ou frequência estável |
| Perplexity-User | Busca ou acesso a página iniciado por uma solicitação do usuário | Inclusão no rastreamento automatizado ou em treinamento |
Em qualquer avaliação, salvo a resposta completa e as fontes citadas. A existência de links facilita a verificação pelo usuário, mas não demonstra que todas as afirmações da resposta foram corretamente apoiadas por cada fonte.
Busca Web no Claude e os Agentes da Anthropic
Claude pode pesquisar a web quando a pergunta se beneficia de informação atual e, conforme a documentação da Anthropic, respostas que usam essa busca incluem citações e links para verificação. O acesso ao recurso pode variar conforme a versão, as configurações do usuário ou as regras de uma organização, então a condição do teste precisa ser anotada.
A Anthropic documenta três agentes diferentes: ClaudeBot, relacionado à coleta de conteúdo para desenvolvimento de modelos; Claude-SearchBot, voltado a melhorar resultados de busca; e Claude-User, usado quando pessoas pedem ao Claude para acessar sites. A empresa declara que os proprietários de sites podem gerenciar esses agentes em robots.txt.
Eu não agrupo os três agentes em um só campo de relatório. Um bloqueio de ClaudeBot não é necessariamente equivalente a bloquear Claude-SearchBot; permitir acesso por Claude-User, por sua vez, não demonstra que o conteúdo foi indexado para busca. O log precisa preservar o nome do agente e o resultado HTTP para que a análise tenha significado.
| Agente da Anthropic | Finalidade descrita | Pergunta útil na auditoria |
|---|---|---|
| ClaudeBot | Coleta de conteúdo que pode contribuir para modelos | O objetivo de treinamento está autorizado ou bloqueado? |
| Claude-SearchBot | Navegação para melhorar qualidade dos resultados de busca | O site permite o rastreamento de busca e responde sem bloqueio? |
| Claude-User | Acesso em resposta a pedidos de usuários | A página pode ser obtida durante uma interação com busca? |
As regras de disponibilidade de busca podem mudar com o produto. Para avaliar presença no Claude, eu confirmo se a busca estava habilitada e guardo a resposta e as fontes, em vez de comparar um teste com web search ligado a outro sem essa capacidade.
O Impacto das Diferenças de Crawlers no SEO Técnico e WAF
As diferenças significam que robots.txt, WAF e logs precisam ser interpretados por agente e finalidade, não por uma categoria genérica chamada “bot de IA”. Algumas empresas separam descoberta para busca, acesso solicitado por usuário e coleta para treinamento; os nomes, os controles e os efeitos não são iguais.
Um User-Agent identifica uma requisição conforme os sinais declarados pelo agente, mas não prova por si só a finalidade legítima do tráfego. Eu valido os intervalos de IP publicados pela plataforma e verifico a resposta do servidor, especialmente quando uma configuração de CDN ou WAF pode bloquear parte dos acessos.
| Camada de diagnóstico | Verificação | Erro de interpretação comum |
|---|---|---|
| robots.txt | Regra aplicada a cada User-Agent específico | Assumir que um Disallow cobre todos os usos do fornecedor |
| WAF e CDN | Requisição, IP publicado e resposta retornada | Confiar apenas na string de User-Agent sem conferir origem |
| HTML e renderização | Conteúdo principal disponível na resposta recebida | Presumir que o conteúdo visível no navegador chegou igual ao crawler |
| Logs | Agente, URL, data, status HTTP e bloqueio | Somar bots de treinamento, busca e acesso solicitado pelo usuário |
| Controle editorial | Snippets, noindex e conteúdo público | Confundir controles do Google com controles de outros produtos |
O artigo sobre rastreadores de IA no robots.txt vai aprofundar a diferença entre busca, treinamento e acesso a pedido de usuários. O pilar de GEO técnico, rastreamento e dados estruturados vai conectar esses agentes a HTTP, renderização e interpretação do conteúdo.
Como comparar visibilidade sem misturar métricas?
Compare cada plataforma com um protocolo repetível e registre a resposta, a configuração de busca e as fontes observadas. Uma citação vista em uma execução é uma observação daquela execução, não uma medida universal de visibilidade.
Eu uso um conjunto estável de perguntas representativas das tarefas do público. Para cada teste, registro idioma, país ou localização, data, produto, modo de busca, texto exato da pergunta, URLs citadas e o critério usado para classificar menção, citação ou recomendação. Se a interface puder pesquisar automaticamente, marco esse estado também.
| Campo do teste | O que registrar | Motivo |
|---|---|---|
| Plataforma | Produto e experiência específica | AI Overviews não é o mesmo recurso que AI Mode |
| Configuração | Search, web search, Research ou modo disponível | Recursos ativados podem mudar a resposta |
| Consulta | Pergunta exata e contexto da conversa | Pequenas mudanças podem alterar a intenção |
| Localização e idioma | País ou localização e idioma usado | Resultados podem depender do contexto geográfico |
| Data | Data e, quando útil, horário da observação | Busca e páginas mudam com o tempo |
| Resposta e fontes | Texto exibido e URLs citadas | Permite conferir se a fonte sustenta a afirmação |
| Classificação | Menção, citação, recomendação, erro ou ausência | Evita resumir sinais distintos em uma única contagem |
Não some impressões do Search Console, sessões atribuídas, menções manuais e citações detectadas por software em um único número sem explicar unidade e método. o artigo de como medir GEO sem métricas inventadas vai organizar as fontes de evidência por plataforma. O texto existente sobre Share of Model pode ajudar a definir uma métrica de amostra, desde que o denominador e as limitações sejam explícitos.
Diretrizes Editoriais que Fortalecem Presença nos Quatro Ecossistemas
Eu compartilho práticas de qualidade editorial e acesso, não supostos sinais universais de seleção. O conteúdo precisa cumprir uma necessidade, apresentar afirmações verificáveis e deixar claro o que é opinião, procedimento, dado ou experiência.
A página deve ser encontrável por navegação e links internos, ter informação principal acessível em texto e ser revisada conforme a fonte de verdade. Em páginas comerciais, isso também significa manter oferta, disponibilidade e especificações coerentes com o catálogo. Dados estruturados devem descrever a página, não tentar substituir o conteúdo nem prometer citação.
Para cada afirmação importante, eu recomendo registrar quatro itens: fonte, escopo, data de verificação e responsável. Esse processo melhora a manutenção editorial e ajuda a investigar respostas incorretas sem partir da hipótese de que uma mudança de formato, por si só, alterou a seleção de uma plataforma.
O conteúdo existente de Branding Semântico complementa a discussão de identidade e consistência da marca. o artigo sobre auditoria de consistência de marca nas IAs vai tratar da comparação de respostas e da correção de divergências.
Roteiro de Implementação Multiplataforma em 8 Passos
Comece por corrigir a base técnica e editorial, depois faça testes separados por plataforma com um protocolo de observação comum. A equipe não precisa criar quatro versões do mesmo site; precisa saber onde as regras documentadas divergem e medir cada resultado sem misturar causas.
- Selecione páginas e tarefas prioritárias. Escolha URLs que respondem às perguntas mais importantes para clientes ou leitores.
- Verifique o acesso técnico. Revise robots.txt, HTTP, HTML renderizado, WAF e logs para cada User-Agent relevante.
- Separe os objetivos de cada crawler. Registre se o agente é para busca, acesso solicitado pelo usuário ou treinamento.
- Revise utilidade e evidências. Confira fonte, escopo, data, autoria e clareza das informações principais.
- Monte consultas de avaliação. Use perguntas reais e mantenha o texto, idioma e localização estáveis entre rodadas.
- Capture as respostas e as fontes. Guarde a plataforma, a configuração, a data e os links apresentados.
- Classifique sem extrapolar. Separe citação, menção, tráfego e impressão e declare o limite de cada métrica.
- Priorize a correção que altera uma decisão. Resolva primeiro bloqueios, erros de informação ou lacunas de página que afetam usuários e negócio.
A pauta de GEO por maturidade ajuda a ordenar esse trabalho antes de comprar ferramentas ou escalar testes. A biblioteca de Prompts para SEO pode apoiar a construção de perguntas de avaliação, mas cada resposta observada precisa ser verificada. Para projetos de loja virtual, o ebook SEO para E-commerce pode complementar a revisão de categorias, produtos e conteúdo de apoio.
Qual plataforma sua equipe deve priorizar?
Priorize a plataforma conforme o público, os objetivos e a evidência disponível na sua operação, não por uma lista universal de “IA mais importante”. Se o tráfego orgânico no Google é central, comece por AI Overviews e dados do Search Console; se clientes usam busca conversacional, inclua ChatGPT Search, Perplexity ou Claude no protocolo de observação.
O modelo comparativo não tenta prever qual mecanismo citará uma página. Ele ajuda a organizar o que está documentado, separar controles técnicos, avaliar a presença com método e identificar lacunas que afetam mais de uma experiência.
Na sua operação, qual diferença entre plataformas já mudou uma decisão técnica ou editorial: o rastreador, o comportamento de busca, as fontes citadas ou os dados disponíveis para mensurar?