O erro mais caro em uma política de rastreamento raramente é simplesmente permitir ou bloquear todos os bots. Eu começo perguntando qual finalidade cada agente cumpre, porque busca, treinamento e acesso iniciado por usuário podem ter nomes parecidos, mas obedecem a controles diferentes.
Para controlar rastreadores de IA, primeiro identifico o agente e sua finalidade, depois configuro o robots.txt para os crawlers que respeitam esse protocolo e verifico as regras de CDN, WAF e servidor. Por fim, comparo as decisões com logs e respostas HTTP, sem tratar o nome declarado pelo bot como prova de identidade.
Uma regra de robots.txt pode expressar uma preferência de rastreamento para um agente cooperativo. Ela não autentica quem fez a requisição e não protege conteúdo privado. Além disso, os provedores documentam comportamentos diferentes para visitas disparadas por uma pergunta ou por um link fornecido pelo usuário.
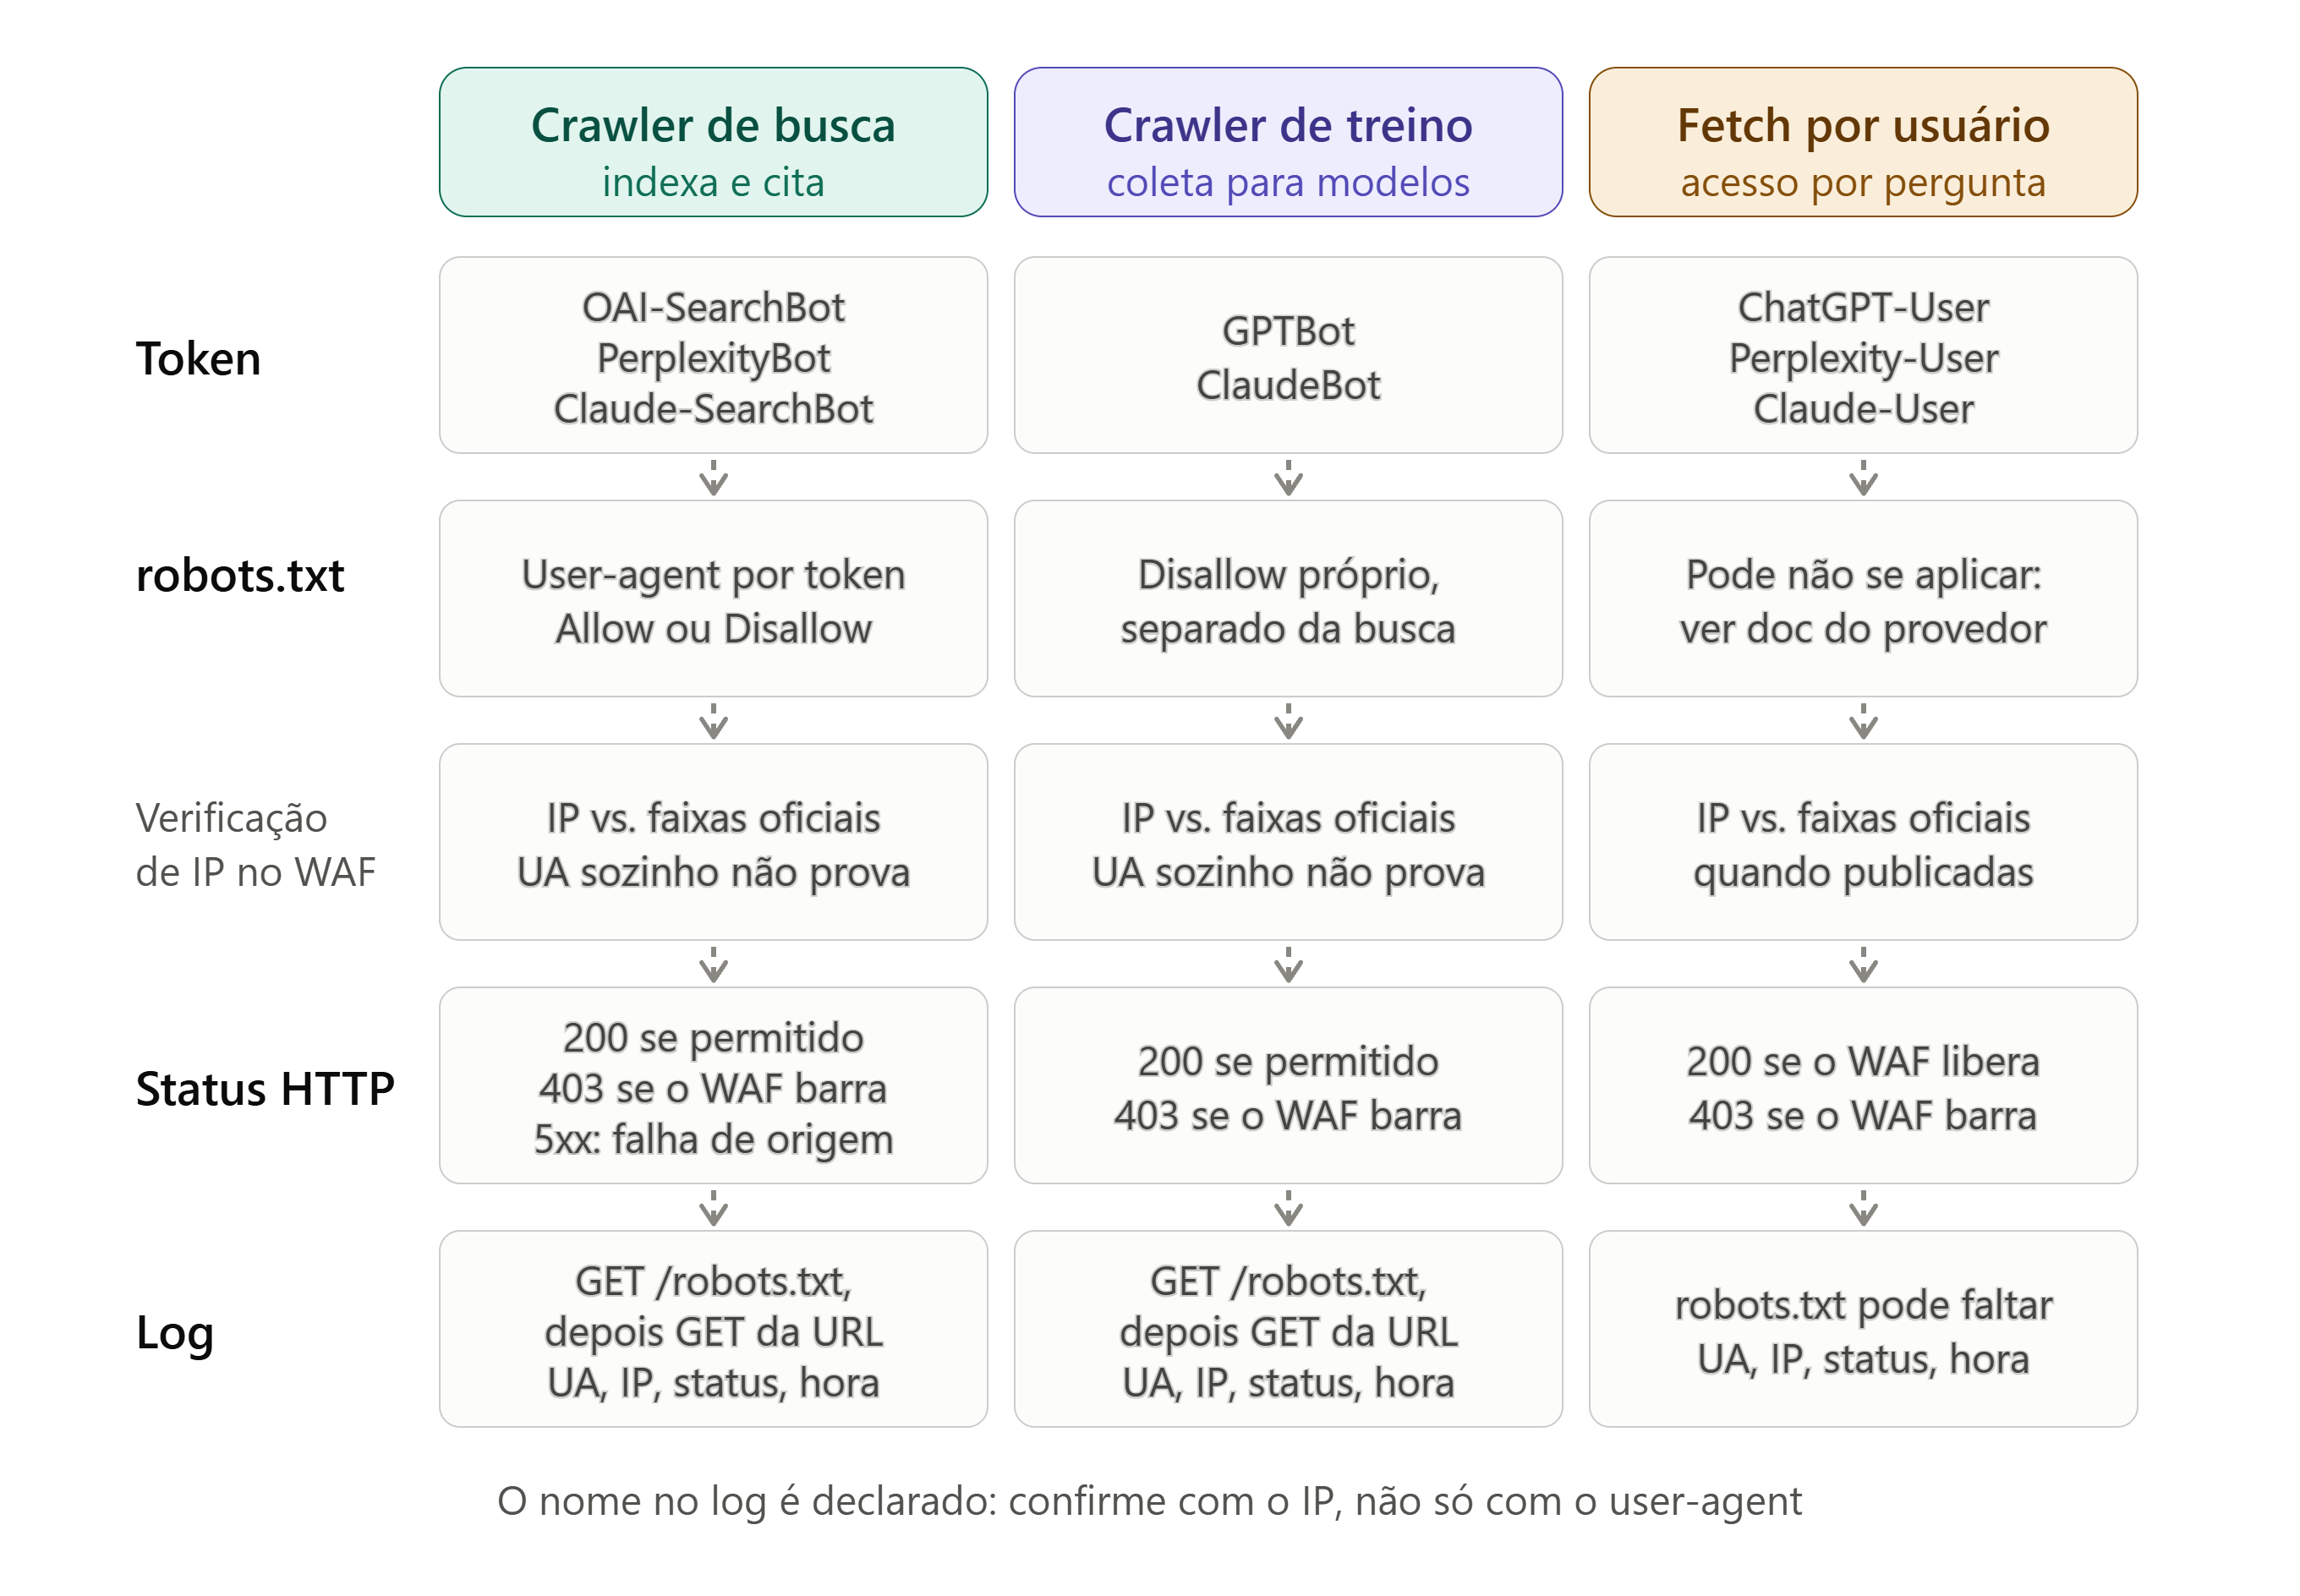
Identificação vs. Autenticação de Rastreadores de IA
O User-Agent ajuda a classificar uma requisição como declarada por um agente conhecido, mas qualquer cliente HTTP pode enviar uma string semelhante. Para permitir acesso especial ou diferenciar um crawler legítimo de uma requisição forjada, eu combino o token esperado com a origem de rede publicada pelo provedor e confirmo a decisão registrada no WAF.
Eu separo três classes de tráfego. O bot de busca descobre ou atualiza páginas para resultados e respostas com busca. O bot de treinamento coleta conteúdo que pode ser usado no desenvolvimento de modelos. O fetch de usuário acessa uma página em resposta a uma ação específica, como uma pergunta ou um link fornecido durante uma conversa.
Essas classes não são equivalentes. Uma organização pode querer permitir o crawler de busca e recusar o de treinamento, ou aceitar um fetch solicitado pelo usuário sem autorizar uma coleta contínua. A política deve refletir essa escolha, não uma interpretação genérica do nome do provedor.
Mapa de User-Agents: OpenAI, Perplexity, Anthropic e Google
Os três provedores documentam agentes separados para parte de suas atividades, mas os controles não são idênticos. Eu consulto as páginas oficiais antes de escrever regras, porque nomes, intervalos de IP e comportamento de fetch podem mudar.
| Provedor e agente | Finalidade documentada | Como interpretar o controle |
|---|---|---|
| OpenAI, OAI-SearchBot | Rastreamento para resultados de busca no ChatGPT | O controle de busca usa esse token em robots.txt; a documentação também recomenda permitir os IPs publicados para exibição em resultados |
| OpenAI, GPTBot | Coleta de conteúdo que pode ser usado no treinamento de modelos | A regra é independente de OAI-SearchBot, permitindo escolhas distintas para busca e treinamento |
| OpenAI, ChatGPT-User | Acesso ligado a ações iniciadas por usuários | Não é crawler automático; a OpenAI informa que regras de robots.txt podem não se aplicar e que ele não controla a inclusão em Search |
| Perplexity, PerplexityBot | Rastreamento para exibir e linkar sites nos resultados de busca | A Perplexity diz que esse bot não é usado para coletar conteúdo para treinamento de modelos |
| Perplexity, Perplexity-User | Acesso a páginas para responder ações de usuário | A documentação diz que geralmente ignora robots.txt; não trate uma diretiva como bloqueio garantido desse fetch |
| Anthropic, ClaudeBot | Coleta de conteúdo que pode contribuir para treinamento | robots.txt é o mecanismo indicado pela Anthropic para registrar a preferência de exclusão |
| Anthropic, Claude-SearchBot | Navegação e indexação para melhorar resultados de busca | A Anthropic documenta uma finalidade separada de ClaudeBot e oferece controle por agente em robots.txt |
| Anthropic, Claude-User | Acesso a sites em resposta a perguntas de usuários | A Anthropic informa que uma diretiva pode impedir esse acesso direcionado pelo usuário |
A diferença entre esses agentes é operacional. A documentação da OpenAI permite separar, por exemplo, OAI-SearchBot de GPTBot; a Perplexity diferencia o crawler de busca de seu fetcher de usuário, que geralmente ignora o arquivo; a Anthropic descreve controles separados para busca, treinamento e acesso iniciado por usuário.
Na minha auditoria, essa matriz vira uma decisão por token: permitir, bloquear, limitar frequência ou investigar. Não converto automaticamente uma preferência sobre treinamento em bloqueio de busca, nem presumo que uma regra que funciona para um crawler controle um fetch iniciado por usuário.
Limites Reais do Protocolo robots.txt para Agentes Generativos
O robots.txt expressa regras para agentes que escolhem respeitá-las. Ele não é autenticação, controle de acesso ou mecanismo de confidencialidade; páginas privadas precisam de autorização no servidor, na aplicação ou na camada de identidade.
Se a estratégia for permitir busca e recusar treinamento onde os provedores oferecem controles separados, a configuração pode ser explícita por agente. O exemplo abaixo é apenas um modelo de intenção, não uma recomendação universal para toda empresa:
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /

User-agent: PerplexityBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: ClaudeBot
Disallow: /
As diretivas do exemplo tratam dos crawlers nomeados. Elas não prometem impedir toda visita de usuário, não substituem regras de firewall e não escondem uma URL que já esteja acessível publicamente. Para OpenAI e Perplexity, os documentos esclarecem que fetches associados a ações de usuários podem não seguir robots.txt; para Claude, a Anthropic documenta o controle de Claude-User por essa via.
Eu verifico o arquivo na raiz de cada host utilizado pela operação. https://example.com/robots.txt, https://www.example.com/robots.txt e o arquivo de um subdomínio pertencem a escopos diferentes. Também confirmo se a resposta é legível e se a CDN ou o WAF não apresenta um desafio, redirecionamento ou bloqueio antes que o agente consiga consultar as regras.
Os tokens costumam ser mais estáveis para configuração do que a versão completa da string do navegador. A própria documentação de provedores informa que versões de User-Agent podem mudar. Quando crio regras no WAF, consulto os endpoints oficiais de IP do agente e atualizo a lista conforme a fonte do provedor, sem copiar para o artigo um intervalo que pode envelhecer.
Como validar IPs e evitar bloqueios acidentais no WAF e CDN?
Uma regra de WAF que permite qualquer requisição contendo PerplexityBot ou OAI-SearchBot pode ser imitada por outro cliente. Para uma exceção de segurança, eu uso a combinação de token esperado, faixa de IP publicada pelo provedor e escopo mínimo necessário, mantendo a decisão visível nos logs da borda.
Essa configuração exige atenção à ação e à ordem das regras. Uma permissão inserida depois de uma regra de desafio pode nunca ser avaliada; uma exceção ampla pode liberar caminhos que não precisam ser acessíveis. Na orientação da Perplexity para alguns WAFs, por exemplo, as faixas de IP de cada agente devem ser combinadas com o respectivo User-Agent, e as regras precisam anteceder as regras que bloqueiam o tráfego.
| Evidência observada | Interpretação inicial | Próxima checagem |
|---|---|---|
| 200 no HTML | O servidor entregou uma resposta | Verificar conteúdo, renderização e se a resposta veio do edge esperado |
| 301 ou 302 | A requisição foi redirecionada | Conferir URL final, cadeia, host e resposta após o redirecionamento |
| 401 ou 403 | Acesso negado, autenticado ou desafiado | Identificar qual regra de aplicação, CDN ou WAF tomou a decisão |
| 404 ou 410 | A URL não está disponível nesse caminho | Comparar URL requisitada, canonicalização e estado da página |
| 429 | Houve limitação de frequência ou proteção contra excesso | Revisar rate limit, janela, agente e impacto sobre requisições legítimas |
| 5xx | O servidor ou a borda não concluiu a requisição | Correlacionar horário, região, upstream, timeout e identificador do evento |
Um 200 prova apenas que houve uma resposta HTTP bem-sucedida naquela requisição. Não prova que o crawler interpretou a página, que a incluiu em um índice, que uma resposta citou o conteúdo ou que uma ação iniciada por usuário será permitida sob outra regra.
Auditoria de Logs de Servidor e Diagnóstico de Status HTTP
O diagnóstico precisa combinar a requisição recebida pelo edge, a decisão do WAF e a resposta do servidor de origem. Se eu olho apenas o log da aplicação, posso deixar passar um bloqueio da CDN; se olho apenas o edge, posso não perceber que a origem serviu um HTML incompleto ou uma página de erro com status 200.
Eu registro, quando disponíveis, data e hora com fuso, IP de origem, User-Agent, host, caminho, método, status HTTP, bytes transferidos, ação do WAF, identificador da requisição, upstream e latência. Para cada teste, guardo também a versão do robots.txt e a intenção associada ao token analisado.
Um teste local com curl pode verificar se o site responde de forma diferente quando recebe uma string de User-Agent específica:
curl -sS -A 'OAI-SearchBot' -D - -o /dev/null \
  'https://www.example.com/pagina-publica'
Esse comando simula somente a string enviada no cabeçalho. Ele não prova que a origem de IP é da OpenAI, Perplexity ou Anthropic, não aciona necessariamente a mesma regra da borda e não representa uma busca feita por um usuário real. Eu uso o teste para detectar regras dependentes do User-Agent, depois comparo com logs e faixas oficiais do agente.
Para interpretar uma ocorrência, eu cruzo a linha do log com a política esperada. Se o agente deveria ter acesso e recebeu 403, procuro desafio de bot, ACL, regra geográfica ou autenticação. Se recebeu 200, abro a resposta entregue e comparo o conteúdo com o HTML visível. Se não há ocorrência, confirmo se estou consultando a propriedade, o host, o período e o ponto de observação corretos antes de concluir que o crawler não tentou acessar.
Política de Governança de Bots e Checklist de Manutenção
Um runbook registra a preferência da empresa por cada classe de agente e testa se a infraestrutura a executa. O resultado esperado não é “deixar todos os bots entrarem”, mas conseguir explicar qual conteúdo cada agente pode acessar, por qual regra e com qual evidência.
- Inventarie hosts e conteúdo. Liste domínio principal, versões com e sem www, subdomínios, páginas públicas, áreas autenticadas e conteúdo que exige proteção real.
- Defina a preferência por finalidade. Separe busca, treinamento e fetch de usuário; escolha permitir, bloquear, limitar ou investigar por agente.
- Consulte as documentações atuais. Confirme tokens, finalidade, comportamento de robots e endpoints de IP diretamente com o provedor, sem reaproveitar listas antigas.
- Edite o robots.txt por host. Preserve regras para os crawlers já operacionais e valide se grupos específicos e regras gerais não produzem resultados contraditórios.
- Revise CDN e WAF. Combine User-Agent e IP oficial nas exceções necessárias, aplique o menor escopo possível e confira a ordem de avaliação.
- Teste as respostas HTTP. Compare a leitura de robots.txt com páginas representativas, redirects, status e conteúdo entregue na origem e no edge.
- Analise logs por agente e camada. Correlacione requisições, faixa de origem, ação do WAF, resposta HTTP e identificador de evento.
- Documente exceções e reteste. Registre responsável, data, finalidade, mudança aplicada e evidência esperada; repita o teste depois de atualizações no arquivo ou na infraestrutura.
O pilar de GEO técnico: rastreamento, renderização e dados estruturados explica a cadeia mais ampla de acesso e interpretação. A auditoria técnica para citação por IAs ajuda a localizar barreiras em HTTP, HTML, WAF e marcação; o artigo de Schema.org, JSON-LD e renderização JavaScript trata da paridade entre conteúdo visível e dados estruturados.
Quando o rastreamento envolve preço, estoque ou páginas de catálogo, a fonte de verdade também precisa permanecer sincronizada. O ebook SEO para E-commerce dá contexto à operação orgânica de lojas virtuais, e a futura pauta sobre feeds, APIs e observabilidade em GEO aprofundará o ciclo entre sistemas de origem, páginas, atualização e evidência.
Para padronizar verificações e cenários, use a biblioteca de Prompts para SEO como apoio de QA, não como substituto de requisições, logs ou controles de acesso. O guia geral de GEO e o artigo sobre como aparecer em primeiro no Google completam o contexto de descoberta e indexação.
O controle de crawlers é uma decisão de acesso por finalidade, não um botão universal de GEO. Eu começaria pelos agentes que afetam resultados de busca, treinamento ou fetches relevantes para o negócio, depois provaria cada decisão com a resposta HTTP e o log correspondente.
Qual combinação de diretivas, regras de WAF e evidências de log você usa hoje para distinguir um bot legítimo de uma requisição que apenas imita seu User-Agent?