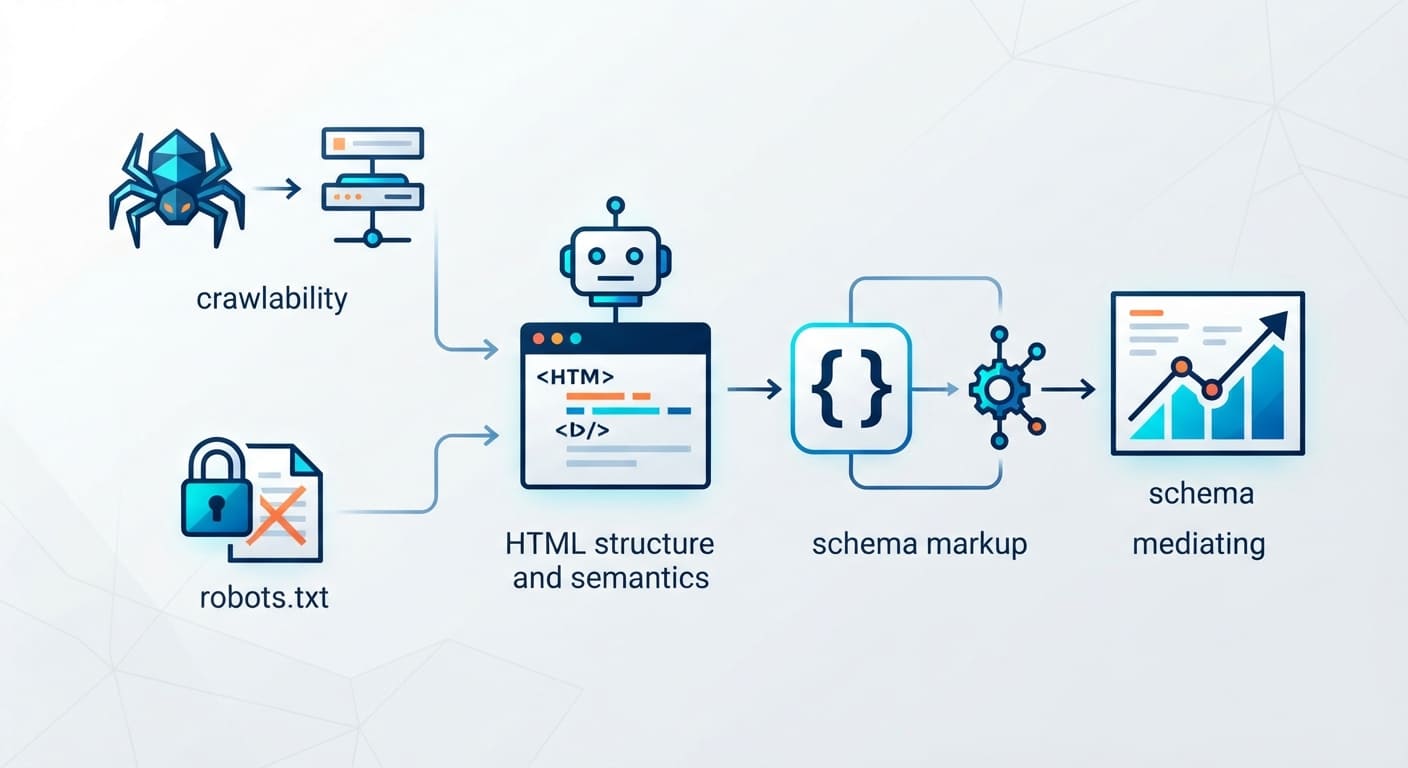
Uma página pode carregar perfeitamente no navegador de um analista e, no mesmo minuto, entregar um documento vazio ou bloqueado para os rastreadores que alimentam mecanismos de busca e respostas generativas. Quando o time tenta ajustar o texto sem antes inspecionar a camada HTTP, o HTML inicial e as regras de firewall, o diagnóstico confunde sintomas editoriais com falhas puras de infraestrutura.
Para isolar a causa real, eu estruturo a auditoria técnica de GEO em seis camadas dependentes: descoberta da URL, permissão de acesso, status HTTP, paridade do DOM renderizado, diretivas de snippet e consistência de dados estruturados. Como um teste aprovado no Googlebot não significa que agentes como OAI-SearchBot ou PerplexityBot receberam o mesmo retorno, essa verificação precisa ser feita por URL e por mecanismo.
O Escopo Real de uma Auditoria Técnica de GEO
Uma auditoria técnica confirma se as condições de acesso e interpretação estão presentes para uma URL em um ambiente de teste. Ela pode localizar bloqueios, respostas incorretas, conteúdo ausente na renderização e inconsistências de metadados, mas não determina sozinha por que uma página foi escolhida ou não como fonte.
Eu separo elegibilidade técnica de seleção editorial ou algorítmica. A primeira pergunta se a página está acessível, indexável e representada corretamente. A segunda envolve relevância para a consulta, qualidade, evidência, contexto e decisões internas do mecanismo, fatores que uma checagem de robots.txt ou de JSON-LD não resolve.
| Camada | O que a auditoria verifica | O que ela não prova |
|---|---|---|
| Descoberta | Se a URL está ligada internamente e consta nos inventários pertinentes | Que o mecanismo vai visitá-la |
| Acesso | Se robots.txt, CDN, firewall e autenticação permitem a requisição | Que a página será indexada ou citada |
| Resposta | Se a URL entrega status HTTP e destino esperados | Que o conteúdo é relevante para uma consulta |
| Renderização | Se o texto principal está disponível no HTML ou DOM que o mecanismo consegue processar | Que todos os agentes executam JavaScript da mesma forma |
| Interpretação | Se título, texto, canonical, controles de snippet e schema são coerentes | Que dados estruturados geram uma citação |
| Medição | Se há observações em Search Console, logs ou testes documentados | Que os dados representam todos os sistemas ou respostas |
O guia de arquitetura de conteúdo para citação por IAs trata intenção, resposta e evidência. Este satélite complementa o pilar, verificando se o conteúdo e os controles técnicos chegam a ser processados como a equipe espera.
Separação entre Bots de Busca, Treinamento e Sessões de Usuário
Classifique cada agente pelo propósito documentado antes de editar robots.txt ou regras do firewall. Uma mesma empresa pode operar agentes distintos para indexação de busca, desenvolvimento de modelos e recuperação de uma página solicitada por uma pessoa.
A documentação da OpenAI, por exemplo, diferencia OAI-SearchBot, GPTBot e ChatGPT-User. OAI-SearchBot é associado à busca no ChatGPT, GPTBot ao rastreamento de conteúdo que pode ser usado no treinamento dos modelos, e ChatGPT-User a algumas ações iniciadas pelo usuário; a própria documentação diz que esses controles são independentes.
| Ambiente ou agente | Pergunta técnica para a auditoria | Ação de diagnóstico |
|---|---|---|
| Google Search, incluindo recursos generativos | A página está indexada e elegível para snippet? O acesso de Googlebot está liberado no site e na infraestrutura? | Conferir URL Inspection, robots.txt, resposta recebida e controles de snippet |
| OpenAI, busca do ChatGPT | OAI-SearchBot pode acessar a página e a requisição chega à origem? | Conferir diretiva por user-agent, resposta HTTP e intervalos de IP publicados pelo fornecedor |
| OpenAI, outros usos | A equipe separou o controle de busca dos controles de treinamento e de recuperação iniciada pelo usuário? | Revisar cada user-agent e a finalidade declarada, sem tratar um agente como substituto de outro |
| Perplexity e Claude | O site possui regras próprias para os agentes atualmente documentados por cada fornecedor? | Conferir a documentação vigente, o robots.txt, a CDN ou WAF e os logs de cada agente |
Não recomendo copiar uma regra pronta de outro domínio sem entender o efeito de cada linha. Um Disallow aplicado ao user-agent errado pode bloquear uma finalidade que a empresa pretendia permitir, ou deixar acesso aberto onde queria restringir.
o guia sobre rastreadores de IA no robots.txt detalhará finalidades, controles e validação por logs para ChatGPT Search, Perplexity e Claude. No diagnóstico atual, o princípio é manter uma matriz por fornecedor e conferir a documentação do próprio serviço antes de alterar políticas.
Diagnóstico de robots.txt, WAF, CDN e Respostas HTTP
Leia o robots.txt que o agente realmente consegue buscar e verifique separadamente as regras da CDN, do WAF, do servidor e de qualquer proteção contra bots. Uma diretiva permissiva no arquivo não ajuda se a requisição recebe um desafio, bloqueio, limite de taxa ou erro antes de chegar ao conteúdo.
Eu começo com um conjunto pequeno de URLs representativas: uma página central, uma página renderizada com JavaScript, uma URL de produto ou serviço quando pertinente, e uma página que tenha apresentado problema. Depois comparo a resposta da origem e da borda de segurança, usando os logs para localizar status e motivos de bloqueio.
| Sinal observado | Hipótese a verificar | Próxima checagem |
|---|---|---|
| 200 com HTML quase vazio | A aplicação pode depender de hidratação no navegador | Comparar HTML inicial com DOM renderizado e texto principal |
| 403 | Política de acesso, firewall, autenticação ou regra geográfica pode bloquear a requisição | Correlacionar horário, user-agent, IP e regra aplicada no WAF |
| 429 | Rate limit ou controle de frequência pode limitar o agente | Verificar limites por rota, IP e janela de tempo nos logs |
| 5xx | Erro de origem, CDN ou aplicação | Comparar logs da borda e do servidor para a mesma requisição |
| 200 com desafio ou CAPTCHA | O código HTTP não representa uma página de conteúdo utilizável | Inspecionar corpo da resposta, desafio e eventos do provedor de segurança |
| 404 ou redirecionamento inesperado | URL, regra de rota ou destino pode estar incorreto | Testar URL final, cadeia de redirecionamento e status do destino |
| robots.txt inacessível ou com sintaxe inesperada | O rastreador pode não ler as regras como a equipe planejou | Buscar o arquivo por host e protocolo, verificar status e validar grupos por agente |
Um 200 OK é apenas uma parte do diagnóstico. Eu verifico se o corpo contém o conteúdo esperado e se não foi substituído por uma tela de consentimento, bloqueio ou carregamento infinito. Quando o fornecedor publica intervalos de IP, comparo a origem da requisição com a lista atual, em vez de confiar somente no texto do user-agent.
Isso também reduz o risco de criar uma exceção ampla no WAF para qualquer requisição que alegue ser um bot. O allowlist deve ser específico ao serviço e mantido de acordo com as instruções oficiais, sem abrir o site inteiro a tráfego não verificado.
Como verificar o conteúdo renderizado em páginas com JavaScript?
Compare o HTML recebido sem execução de JavaScript com o DOM renderizado e confirme se o conteúdo principal, os links e os metadados importantes aparecem corretamente. Uma página que funciona para uma pessoa com navegador, cookies e scripts habilitados pode oferecer uma resposta diferente a um agente que não reproduz o mesmo ambiente.
No caso do Google, a documentação orienta que o conteúdo importante esteja disponível em formato textual e descreve requisitos de rastreamento e indexação para AI Overviews e AI Mode. Por isso, eu verifico primeiro se o texto essencial está presente e acessível sem depender de uma interação não necessária.
Faça a comparação em pelo menos quatro pontos: título e descrição, texto principal, links internos e conteúdo de dados estruturados. Se o HTML inicial contém apenas um shell de aplicação, avalie renderização no servidor ou pré-renderização para melhorar a disponibilidade do conteúdo, respeitando as limitações técnicas do projeto.
| Elemento | HTML inicial | DOM renderizado | Resultado esperado |
|---|---|---|---|
| Título e H1 | Presente ou ausente | Presente ou alterado | Título coerente com a página e o assunto |
| Resposta principal | Texto completo ou placeholder | Conteúdo visível após scripts | Resposta essencial disponível em texto |
| Navegação interna | Links com href ou eventos isolados | Links presentes no DOM | Destinos funcionais e rastreáveis |
| Canonical | URL definida no HTML | Valor preservado após scripts | Uma URL preferencial consistente |
| JSON-LD | Bloco inicial ou ausente | Bloco injetado ou modificado | Dados correspondentes ao conteúdo visível |
Se uma rota depende de JavaScript, teste também o comportamento sem sessão autenticada e sem interações anteriores. O usuário pode ter acessado a página através de uma navegação já iniciada, enquanto o rastreador começa por uma URL profunda sem o estado do navegador.
o artigo sobre Schema.org, JSON-LD e renderização JavaScript aprofundará a comparação entre HTML inicial, DOM renderizado, texto visível e marcação estruturada.
Controles de Snippet e Paridade de Dados Estruturados
Confira se os controles de indexação e pré-visualização correspondem à decisão editorial para aquela página, e se a marcação estruturada descreve informações que também estão disponíveis para o usuário. Não trate robots.txt, noindex, nosnippet, max-snippet e data-nosnippet como controles equivalentes.
Para os recursos de IA do Google, a documentação cita nosnippet, data-nosnippet, max-snippet e noindex como controles que podem limitar o que aparece na Busca. Ela também recomenda que os dados estruturados correspondam ao texto visível e informa que não há um schema especial obrigatório para AI Overviews ou AI Mode.
Antes de editar qualquer regra, registre o objetivo. Bloquear rastreamento, impedir indexação e reduzir trechos exibidos são ações diferentes. Uma regra de noindex, por exemplo, pode retirar a página da elegibilidade para busca; não é uma forma de manter a página indexada e apenas controlar uma frase específica.
| Controle | Função geral no diagnóstico | Erro comum |
|---|---|---|
| robots.txt | Orienta se um rastreador deve buscar determinadas áreas | Usá-lo como se fosse garantia de remoção de uma URL do índice |
| noindex | Sinaliza que a página não deve ser indexada pelo mecanismo que processa a diretiva | Aplicá-lo sem confirmar que isso é compatível com a visibilidade desejada |
| nosnippet | Limita a exibição de trechos no Google Search | Tratar a diretiva como configuração universal para todas as IAs |
| max-snippet | Define um limite de extensão de snippet no Google Search | Assumir que o controle afeta outros fornecedores da mesma forma |
| data-nosnippet | Marca regiões que não devem ser usadas como snippet no Google Search | Ocultar elementos que são necessários para interpretar a página |
| JSON-LD | Descreve entidades e propriedades conforme um vocabulário estruturado | Inserir informações que não aparecem ou não correspondem ao conteúdo real |
Eu valido o JSON-LD como dado, mas também comparo cada propriedade com o texto e a interface da página. Um validador pode confirmar a sintaxe do bloco sem demonstrar que a informação está correta, atualizada ou visível.
Para quem precisa do passo a passo de implementação, o artigo sobre Schema.org, JSON-LD e renderização JavaScript aborda propriedades e validação. O pilar de GEO técnico vai reunir essa camada com rastreamento, renderização e atualização.
Observabilidade e Logs sem Distorcer o Diagnóstico
Use o Search Console para observar os dados de recursos generativos do Google e registre separadamente evidências de outros mecanismos. Nenhuma ferramenta isolada mostra toda a seleção de fontes, e uma impressão ou uma citação observada não prova que uma correção técnica foi a causa.
Em agosto de 2026, o Google informou que o relatório de desempenho generativo do Search Console estava disponível para sites em todo o mundo. O relatório inclui impressões de AI Overviews e AI Mode e permite observar páginas, países, datas e dispositivos; pode não aparecer para propriedades sem impressões suficientes ou excluídas desses recursos.
Para ChatGPT, Perplexity e Claude, mantenha um protocolo independente quando precisar observar citações: registre as perguntas, o idioma, a região, a data, a plataforma, a resposta e as fontes apresentadas. O Search Console do Google não mede diretamente as citações desses outros produtos.
| Fonte de observação | O que pode indicar | O que não permite concluir sozinha |
|---|---|---|
| Search Console, relatório generativo | Impressões de links em AI Overviews e AI Mode, por página e dimensões disponíveis | Visibilidade em produtos de terceiros ou causa de uma mudança |
| Logs de CDN e servidor | Requisições, respostas HTTP, frequência e bloqueios observados | Que uma resposta gerou citação ou foi processada integralmente |
| Testes manuais documentados | Fontes exibidas para um conjunto definido de perguntas e condições | Share of Model universal ou comportamento estável de todos os usuários |
| Analytics e conversões | Sessões e resultados atribuídos segundo a configuração de medição | Todas as interações sem clique ou influência assistida |
O artigo sobre como medir GEO sem métricas inventadas detalha Search Console, citações e diagnóstico multiplataforma. O texto de Share of Model ajuda a estruturar amostras de perguntas e critérios de presença, sem converter um protocolo próprio em métrica oficial universal. Para elaborar uma bateria inicial de perguntas de teste, a biblioteca de Prompts para SEO serve como apoio à pesquisa, não como evidência de citação.
Roteiro Prático de Execução da Auditoria Técnica
Execute a auditoria por URL e por mecanismo, mantendo o mesmo conjunto de testes antes e depois de uma correção. Essa disciplina permite localizar a camada que falhou e evita atribuir mudanças de visibilidade a uma intervenção que não foi isolada.
- Selecione URLs representativas. Inclua modelos de página, rotas críticas e URLs que já apresentaram falhas.
- Defina os mecanismos e agentes. Registre o user-agent relevante, a finalidade documentada e os controles associados.
- Confira descoberta e status. Verifique links internos, sitemap quando pertinente, URL final, resposta HTTP e cadeia de redirecionamentos.
- Leia as regras de acesso. Revise robots.txt por agente, regras de CDN, WAF, autenticação e bloqueios por frequência ou localização.
- Inspecione os logs. Correlacione horário, IP, user-agent, status e regra que afetou cada requisição.
- Compare HTML inicial e renderizado. Confirme texto principal, links, canonical, título, metas e conteúdo estruturado.
- Revise controles de snippet e indexação. Documente se cada diretiva corresponde ao objetivo de visibilidade da página.
- Valide JSON-LD e paridade visível. Confira sintaxe, propriedades, entidade, frescor e correspondência com a interface.
- Registre a linha de base. Guarde o resultado de ferramentas, logs, consultas e observações antes da mudança.
- Corrija uma classe de problema por vez. Refaça o mesmo teste e anote qualquer alteração de status ou conteúdo recebido.
- Monitore a reavaliação. Considere que rastreamento, processamento e relatórios podem levar tempo e variam por sistema.
- Separe correção técnica de resultado de negócio. A melhora no acesso é um resultado técnico; citações, tráfego e conversões exigem mensuração própria.
Eu mantenho um registro por URL com colunas para camada, evidência, impacto provável, responsável, correção, data e resultado do reteste. Assim, uma falha de acesso não se perde em recomendações vagas como “otimizar para IA”.
O que fazer quando a página passa nos testes, mas não recebe citações?
Se a página passa nos testes técnicos e ainda não recebe citações observadas, não invente um bloqueio técnico para explicar a ausência. Mantenha o diagnóstico como inconclusivo na camada técnica e investigue relevância, evidência, cobertura da intenção, reconhecimento da entidade e limitações da amostra.
A auditoria responde se uma barreira específica foi encontrada. Ela não revela toda a lógica de recuperação ou seleção de cada serviço. Em minha prática, essa distinção evita mudanças de robots.txt, schema ou arquitetura sem evidência de que o elemento técnico era o gargalo.
A sequência editorial também pode ajudar: o micro-silo de GEO define se a página cobre uma intenção própria, enquanto a resposta direta para IAs verifica se a unidade editorial apresenta afirmação, escopo e evidência sem perder contexto.
Entregáveis e Priorização Técnica Pós-Auditoria
O resultado esperado é um conjunto de achados reproduzíveis, priorizados por mecanismo e camada, com uma correção técnica atribuída e um reteste definido. O resultado não é uma promessa de citação, porque acesso e elegibilidade são condições a diagnosticar, não garantias de seleção.
Eu priorizo primeiro falhas que tornam a página indisponível ou incorreta: bloqueio inadvertido, erro HTTP, redirecionamento quebrado, conteúdo principal ausente ou metadados que contradizem a página. Depois, reviso melhorias de consistência e medição que ajudam a interpretar o comportamento observado.
O guia de GEO e o conteúdo sobre Arquitetura de Conteúdo para AI Overview ajudam a conectar o diagnóstico a estratégia e conteúdo. Para sites de comércio, o ebook SEO para E-commerce complementa o trabalho com arquitetura de catálogo e páginas transacionais.
Se você encontrou uma barreira técnica em uma plataforma generativa, qual camada foi mais difícil de validar: o acesso via WAF, a renderização do conteúdo, o controle de snippet ou a medição do resultado?