Uma API rápida não garante que a informação mais recente esteja visível para uma IA. Se a página pública mostra um preço antigo, o feed informa outro valor e o sistema de estoque registra uma terceira disponibilidade, a operação publicou versões conflitantes do mesmo fato.
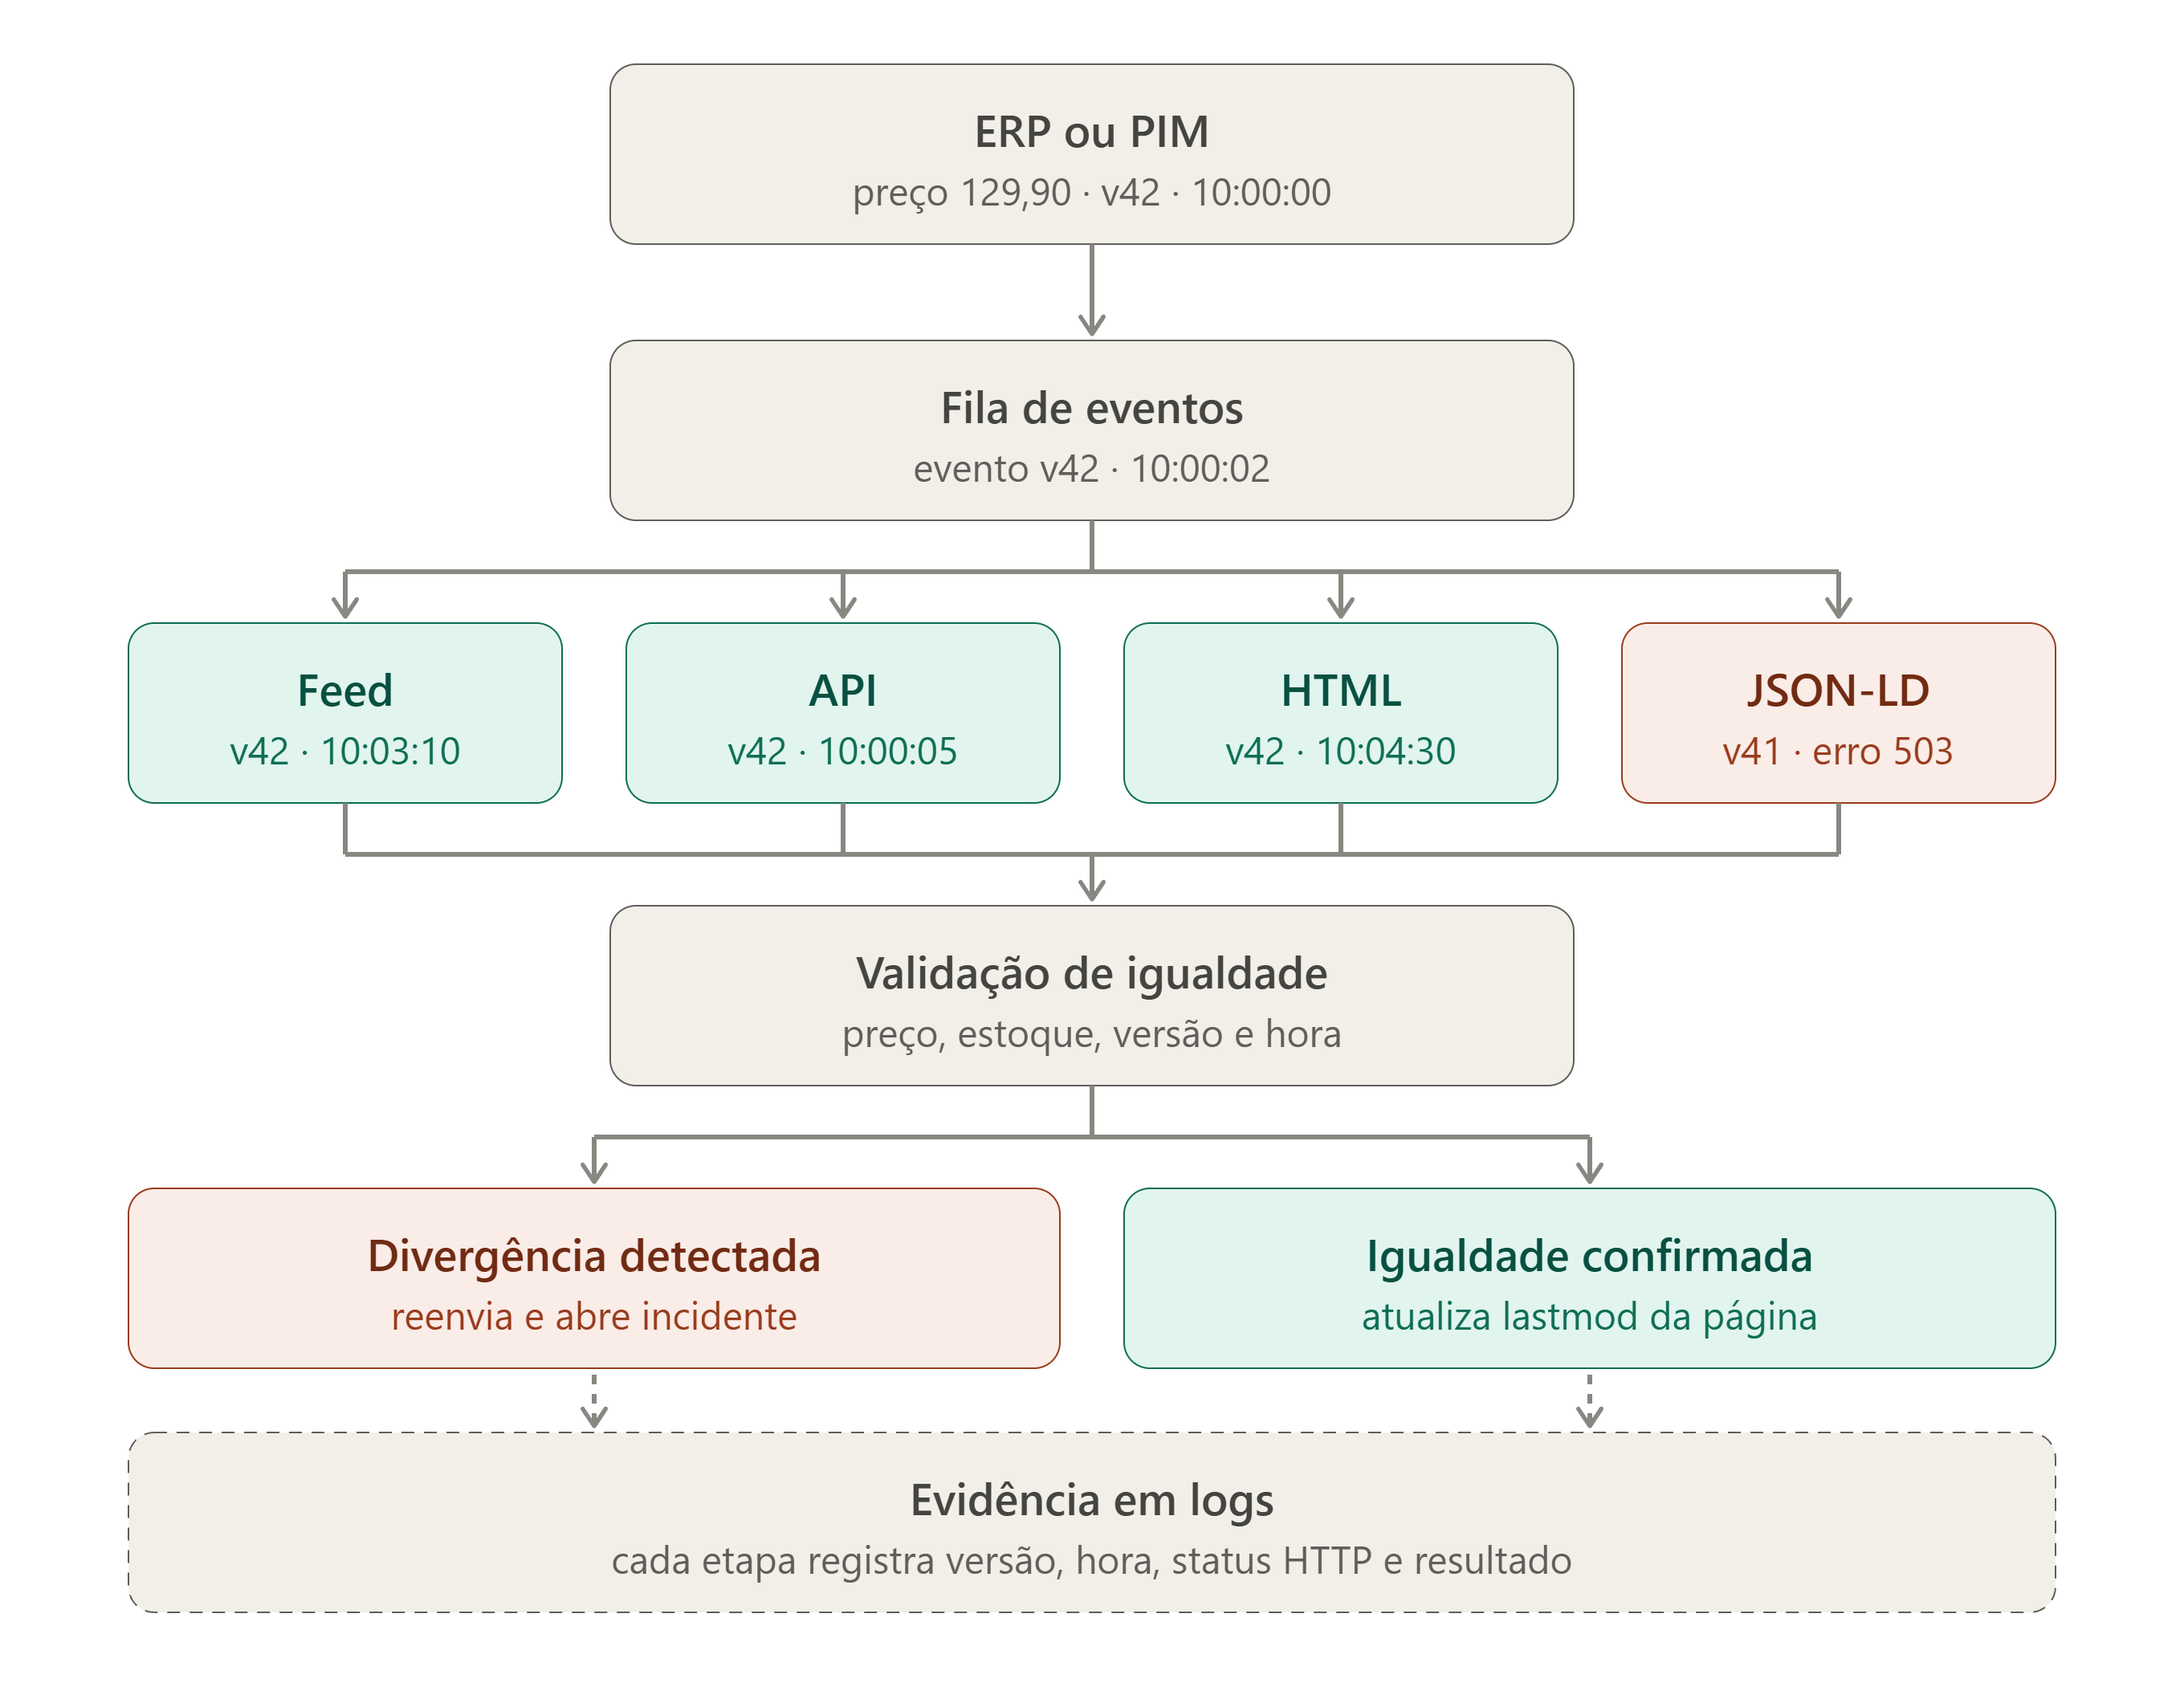
Feeds e APIs funcionam como canais de distribuição técnica, mas a integridade da informação depende de amarrar o sistema de origem (ERP, PIM ou CMS) ao HTML renderizado e ao JSON-LD da página pública, monitorando continuamente o tempo de propagação entre essas camadas.
Esse cuidado vale para produtos, serviços B2B e informações locais. Também exige uma ressalva: um feed só alimenta uma plataforma que o aceita; não há um arquivo genérico que, por si só, torne qualquer preço, estoque ou identidade legível para todos os mecanismos generativos.
Fonte de Verdade e Contrato de Publicação entre Sistemas
Uma fonte de verdade é o sistema autorizado a definir o valor vigente de um atributo, como preço, estoque, nome, cobertura ou horário. O contrato de publicação especifica como esse valor é convertido, distribuído e validado em cada destino.
Em uma operação de e-commerce, o ERP pode governar preços e pedidos, o PIM pode organizar descrições e variantes, e o sistema de estoque pode controlar disponibilidade. Em uma empresa B2B, o CRM ou o catálogo de serviços pode ser responsável por cobertura, condições e status de ofertas. A arquitetura muda conforme a operação, mas cada atributo precisa ter um responsável explícito.
Eu não escolho um “sistema mestre” único para todo o negócio se diferentes domínios têm donos distintos. Em vez disso, mantenho um mapa de atributos: quem é responsável pelo valor, quais sistemas o replicam, em que prazo a mudança deve chegar a cada destino e qual regra detecta a divergência.
| Dado | Fonte de verdade possível | Representações de saída | Verificação principal |
|---|---|---|---|
| Identidade do produto | PIM ou catálogo de produto | Feed, API, página, Product e Offer | Mesmo ID, variante, nome e URL canônica |
| Preço e moeda | ERP, pricing ou plataforma de comércio | Feed, API, página e JSON-LD visível | Valor, moeda, validade e preço público coincidem |
| Estoque e disponibilidade | WMS ou sistema de inventário | Feed, API, página e propriedade de disponibilidade | Estado vigente por variante e horário da última confirmação |
| Oferta ou serviço B2B | Catálogo comercial aprovado | API, página de serviço, ficha e proposta pública | Escopo, elegibilidade, região, prazo e condições são consistentes |
| Endereço, horário e área atendida | Cadastro mestre de unidades | Perfil local, páginas de unidade, diretórios e dados estruturados | Unidade correta, região e período de validade |
| Última alteração pública | CMS ou camada de publicação | HTML, cabeçalho HTTP e sitemap XML | Timestamp reflete mudança significativa que chegou à página |
A documentação do Merchant Center exige identificadores e atributos de produto como preço, disponibilidade e URL de destino, e alerta que dados incorretos ou em conflito com o site podem causar reprovação, elegibilidade limitada ou exibição incorreta. Eu uso esse exemplo para mostrar o custo operacional da divergência, sem transformar os requisitos do Merchant Center em regra universal para todas as IAs.
Papel de Cada Camada: Feeds, APIs, HTML Público e JSON-LD
Um feed entrega registros estruturados a uma plataforma que declara aceitá-lo; uma API oferece um contrato de consulta ou atualização a consumidores definidos; HTML apresenta a informação na página pública; JSON-LD descreve dados estruturados que correspondem ao conteúdo visível. Nenhum desses canais substitui automaticamente os outros.
Para o Google Search, a documentação de produto permite fornecer dados por marcação estruturada nas páginas, por feeds do Merchant Center ou por ambos. O Google recomenda os dois canais para maximizar a elegibilidade de experiências de produto e informa que algumas experiências podem combinar dados do feed e da página. Isso descreve experiências do Google, não garante citação em AI Overviews nem define como ChatGPT, Perplexity ou Claude consomem os mesmos feeds.
Eu penso em paridade de valor, não apenas em validade de formato. Um feed XML pode ser sintaticamente válido e ainda conter uma moeda incompatível com a landing page. Uma API pode responder 200 enquanto entrega um registro de uma variante diferente. Um bloco JSON-LD pode passar na validação e continuar desatualizado em relação ao texto que a pessoa vê.
O artigo de Schema.org, JSON-LD e renderização JavaScript aprofunda validação e paridade do markup. Aqui, o foco é acompanhar o mesmo fato ao atravessar sistemas de origem e destinos de publicação.
Como medir a latência e o frescor de dados no catálogo?
Frescor é o tempo e a confiabilidade com que uma alteração aprovada chega aos canais que a operação controla. Eu o meço entre o registro de origem e a confirmação de publicação, em vez de usar apenas a data de geração do feed ou o horário em que alguém atualizou um dashboard.
Cada mudança deve carregar pelo menos um identificador estável da entidade, uma versão ou timestamp de origem, o valor atualizado, os destinos esperados e o resultado de cada entrega. Em catálogos com variantes, o identificador precisa distinguir o produto pai de cada SKU ou configuração, para que o update não sobrescreva o registro errado.
Um evento de auditoria interno pode seguir esta estrutura ilustrativa:
{
  "entity_id": "SKU-48291-BL",
  "attribute": "availability",
  "source_system": "inventory",
  "source_version": "2026-10-29T18:42:15Z",
  "destinations": [
    "product-page",
    "merchant-feed",
    "product-api"
  ],
  "delivery_status": {
    "product-page": "published",
    "merchant-feed": "accepted",
    "product-api": "updated"
  },
  "validated_at": "2026-10-29T18:43:02Z"
}
Esse JSON é um exemplo de registro de observabilidade, não um padrão exigido por Schema.org ou por um provedor de IA. A equipe pode armazenar os mesmos campos em logs, tabelas de controle ou um fluxo de eventos, desde que preserve a relação entre versão de origem, destino e validação.
Preço e estoque costumam exigir um ciclo de atualização diferente de uma descrição institucional ou de uma política de devolução. Eu defino um SLA por atributo, considerando volatilidade e consequência do erro. Um preço expirado durante uma campanha pode exigir resposta em minutos; uma alteração de posicionamento de marca pode seguir um fluxo de aprovação editorial.
Uso Técnico de Sitemaps, lastmod e Datas Editoriais
O sitemap ajuda mecanismos de busca a descobrir URLs e entender preferências de canonicalização, mas o envio não garante que uma URL será rastreada ou usada. O campo lastmod só deve refletir uma alteração significativa e verificável na página, como mudança no conteúdo principal, nos dados estruturados ou nos links.
Uma atualização em um ERP não justifica, por si só, alterar lastmod se a página pública ainda não recebeu o novo dado. O timestamp deve acompanhar o que efetivamente mudou na URL, não o evento que iniciou a cadeia em outro sistema.
O CMS ou a camada de publicação precisa atualizar o sitemap depois de validar a página. A documentação do Google também diz que os valores de priority e changefreq são ignorados, e que enviar um sitemap é apenas uma indicação, não uma garantia de rastreamento. Por isso, não uso uma data renovada artificialmente como substituto de conteúdo atualizado ou de evidência de acesso.
Para o rastreamento de agentes, verifico também as regras de acesso e os logs descritos no guia de rastreadores de IA no robots.txt. Se o bot não consegue acessar a URL ou se o WAF entrega um desafio, um feed atualizado não corrige sozinho o problema da página pública.
Monitoramento de Paridade e Detecção de Divergências
Observabilidade é a capacidade de reconstruir o que aconteceu com um dado, quando ocorreu, quais sistemas o receberam e em que etapa surgiu uma falha. Ela combina logs, validações automáticas, alertas e amostras de comparação entre a fonte de verdade e os canais publicados.
| Etapa | Evidência para guardar | Falha que o sinal pode revelar |
|---|---|---|
| Alteração na fonte | ID da entidade, atributo, valor, versão e autor | Atualização ausente, duplicada ou sem aprovação |
| Transformação | Regra aplicada, moeda, locale, variante e timestamp | Conversão incorreta, arredondamento ou mapeamento de campo errado |
| Entrega ao destino | Status, resposta, tamanho, identificador da execução e tentativa | Timeout, rejeição, limite de taxa ou erro de autenticação |
| Publicação na página | HTML final, valor visível, URL, canonical e status HTTP | Página não atualizada, cache antigo ou variante trocada |
| Marcação estruturada | JSON-LD renderizado e valores críticos | Divergência entre dado estruturado e conteúdo visível |
| Sinalização de atualização | lastmod e horário da publicação confirmada | Timestamp antecipado, falso ou sem relação com mudança significativa |
| Acesso do crawler | Log de CDN, WAF e origem com agente, caminho e resultado | Bloqueio, resposta incompleta ou acesso à versão errada |
Eu priorizo reconciliações automáticas para campos críticos. Uma validação pode comparar, por ID e locale, preço e estoque de origem com feed e página. Se não houver igualdade, ela abre uma exceção com o valor esperado, o valor encontrado, o timestamp e o sistema responsável, em vez de enviar um alerta genérico de “GEO indisponível”.
Uma amostra manual continua útil para conferir se a resposta pública está inteligível, se uma pessoa consegue ver a informação e se os sistemas identificam a mesma entidade. Mas eu não uso uma resposta isolada de IA como sensor de saúde de todo o catálogo. A auditoria de consistência de marca nas IAs trata das respostas e atribuições; este artigo mede a integridade do fluxo controlado pela organização.
Governança Operacional para Manter Catálogo e Marca Sincronizados
Um runbook define quem mantém cada atributo, como ele se propaga e qual evidência confirma a publicação. Eu aplico a sequência abaixo antes de ampliar o número de feeds ou construir integrações novas.
- Liste entidades e atributos críticos. Separe empresa, produto, variante, serviço e unidade local; identifique os campos que afetam decisão, elegibilidade ou confiança.
- Atribua uma fonte autorizada a cada atributo. Registre sistema, proprietário, regra de aprovação e prazo de atualização esperado.
- Mapeie todos os destinos. Inclua feed, API, HTML, JSON-LD, sitemap, diretórios ou perfis locais, indicando quais plataformas realmente consomem cada canal.
- Crie um contrato de dados. Defina identificadores, locale, moeda, campos obrigatórios, estados permitidos, datas de validade e comportamento para valor ausente.
- Versione a mudança. Emita evento com ID estável, timestamp, sistema de origem e versão sempre que um atributo relevante mudar.
- Valide cada transformação. Compare o valor de origem com a representação final por ID e variante, incluindo conteúdo visível e resposta da API.
- Confirme a publicação antes de sinalizar frescor. Atualize o sitemap e lastmod apenas depois da alteração significativa chegar à página pública.
- Monitore entrega, divergência e acesso. Registre status das APIs e feeds, resposta HTTP, erros no WAF, cache e logs de rastreamento.
- Defina alertas por impacto. Escale divergências de preço, estoque, identidade e segurança com prioridade diferente de uma descrição editorial desatualizada.
- Feche o ciclo com reteste. Depois de corrigir a fonte ou a integração, confirme que a mesma entidade e versão aparecem em cada destino esperado.
Em uma loja virtual, essa governança precisa conversar com catálogo, preço, estoque e conversão. O ebook SEO para E-commerce ajuda a conectar a camada orgânica à operação do catálogo; a biblioteca de Prompts para SEO pode apoiar testes de QA sobre entidades e atributos, sem substituir as conferências diretas nos sistemas.
A visão de conjunto está no pilar GEO técnico: rastreamento, renderização e dados estruturados. Para estruturar a operação mais ampla, a futura pauta de programa de GEO e mensuração de impacto conectará governança e resultado. o artigo de GEO local e governança operacional aplicará os mesmos princípios a endereços, horários, serviços e cobertura.
Feeds, APIs, páginas e sitemaps não formam um atalho para citações. Eles formam uma cadeia que a empresa pode manter verificável. Eu começaria pelos atributos com maior custo de erro, definiria a fonte autorizada e só então mediria o tempo entre a mudança aprovada e a publicação consistente.
Qual atributo da sua operação hoje leva mais tempo para permanecer igual entre a fonte de verdade, o feed, a página pública e os dados estruturados?