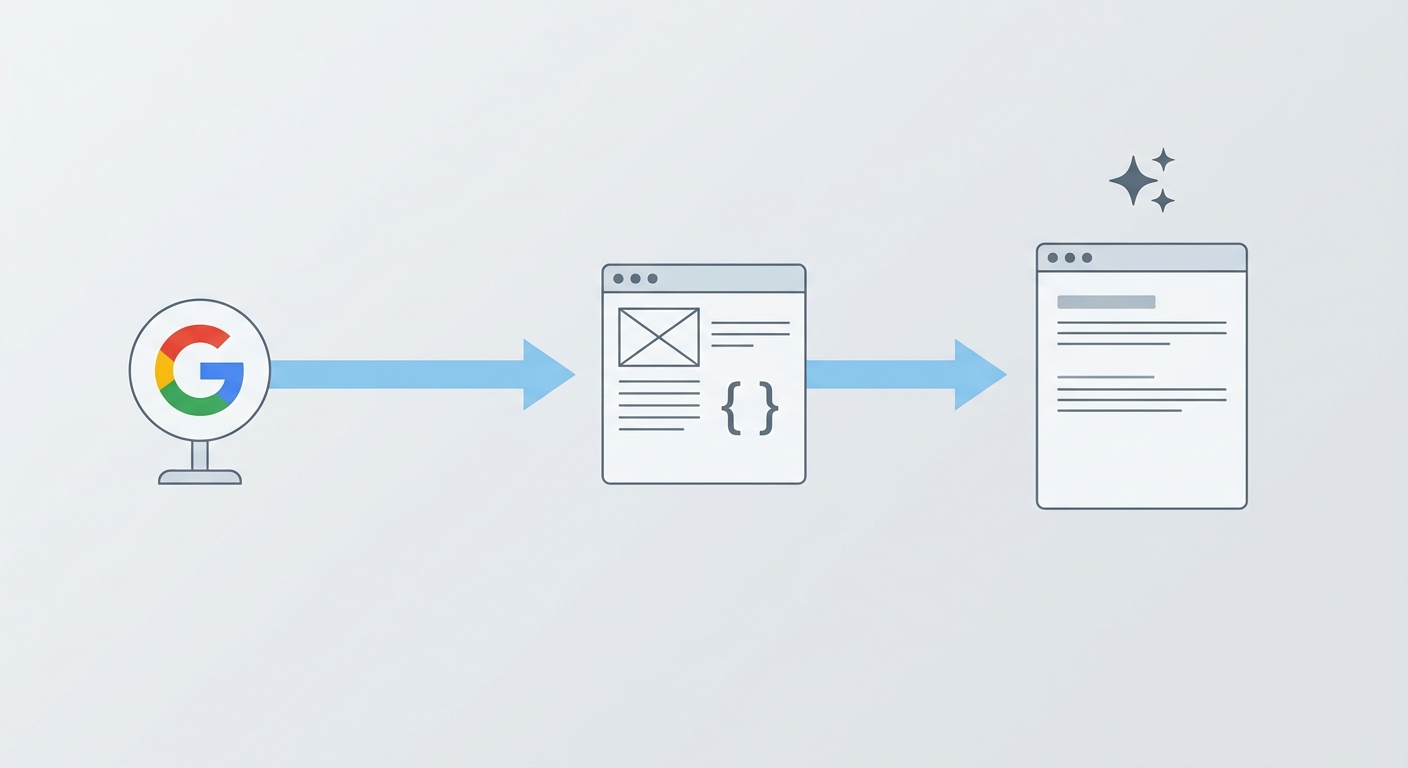
Quando o preço de um produto muda no ERP, a especificação é editada no PIM e o conteúdo entra no CMS, a informação percorre várias camadas antes de virar HTML, JSON-LD e feed público. Se qualquer elo dessa cadeia entrega dados atrasados ou bloqueia rastreadores na borda (CDN/WAF), os motores de busca e sistemas generativos passam a consumir uma versão fragmentada ou desatualizada do seu site.
O GEO técnico resolve exatamente essa engenharia de ponta a ponta: ele conecta a fonte de verdade interna à URL pública, garantindo que descoberta, resposta HTTP, renderização JavaScript e dados estruturados falem a mesma língua para o Google AI Overviews, ChatGPT Search, Perplexity e Claude.
O Escopo do GEO Técnico e a Sincronia entre Sistemas
GEO técnico é a camada de SEO e governança que verifica se informações relevantes podem ser encontradas, acessadas, interpretadas e mantidas consistentes em experiências de busca generativa. Ela ajuda a localizar falhas entre sistemas, mas não controla a seleção de fontes feita por um produto de IA.
Em minha prática, o risco aparece quando os times tratam cada etapa como propriedade de uma área diferente sem definir uma fonte de verdade. Produto atualiza preço no sistema comercial, tecnologia publica uma API, SEO mantém o HTML e uma integração separada gera JSON-LD. Se ninguém compara essas saídas, podem surgir valores, nomes ou condições incompatíveis.
Eu organizo o problema em duas perguntas. Primeiro, o mecanismo consegue chegar à informação e processá-la? Depois, a informação que encontra corresponde ao que a empresa considera correto e atual? A primeira pergunta envolve rastreamento e renderização; a segunda exige consistência entre fontes, página e marcação.
| Pergunta técnica | Camada envolvida | Evidência que eu procuro |
|---|---|---|
| A URL importante pode ser descoberta? | Links internos, sitemap e arquitetura | Caminhos rastreáveis até a página |
| A requisição chega ao conteúdo? | robots.txt, CDN, WAF e servidor | Resposta HTTP e logs por agente |
| O texto principal está disponível? | HTML inicial e renderização | Comparação entre HTML recebido e DOM renderizado |
| Os dados descrevem a página correta? | Metadados, canonical e Schema.org | Paridade entre conteúdo visível e marcação |
| A informação continua atualizada? | PIM, CMS, APIs, feeds e publicação | Datas e valores coerentes em cada camada |
| Há sinal de visibilidade? | Search Console, logs e analytics | Impressões, visitas, fontes e contexto de observação |
O modelo mental de GEO organiza a disciplina em etapas de elegibilidade, compreensão, presença e impacto. Este pilar aprofunda a infraestrutura e os processos necessários para manter a camada técnica em condição de ser avaliada.
As Sete Etapas da Cadeia Técnica de GEO
A cadeia técnica de GEO acompanha uma informação desde sua origem até a evidência observável de acesso ou desempenho. Eu divido o fluxo em sete etapas: fonte de verdade, publicação, descoberta, acesso, processamento, interpretação e observabilidade.
Cada etapa pode funcionar isoladamente e ainda assim produzir uma experiência inconsistente. Uma API pode retornar o estoque correto enquanto a página mostra uma quantidade antiga. Um JSON-LD pode estar sintaticamente válido, mas descrever uma oferta que já expirou. Um rastreador pode buscar uma URL e receber uma resposta de segurança, não o conteúdo.
| Etapa | O que precisa acontecer | Falha típica | Pergunta de controle |
|---|---|---|---|
| Fonte de verdade | A informação tem origem definida e responsável | Existem valores concorrentes em sistemas diferentes | Qual sistema é a referência para este dado? |
| Publicação | CMS, PIM, feed ou API transmite o valor correto | A integração atrasa ou transforma o dado | Quando e como o valor é propagado? |
| Descoberta | Links e mapas do site expõem as URLs prioritárias | Páginas sem links ou rotas escondidas | Como um rastreador chega à URL? |
| Acesso | Regras e infraestrutura permitem a requisição autorizada | robots.txt, WAF ou CDN bloqueia acesso | Qual resposta chega ao agente e à origem? |
| Processamento | HTML e recursos necessários podem ser interpretados | Conteúdo depende de sessão, interação ou script indisponível | O texto principal está no conteúdo recebido? |
| Interpretação | Título, texto, canonical e dados estruturados concordam | Marcações e texto apresentam entidades diferentes | O que a página afirma e o que o JSON-LD descreve? |
| Observabilidade | Mudanças podem ser acompanhadas com método explícito | Equipe confunde rastreamento com citação | Qual evidência mostra cada resultado? |
Em um e-commerce, por exemplo, o preço pode ser atualizado no sistema comercial, enviado ao catálogo, renderizado no HTML, representado em Offer e publicado no feed do Merchant Center. Minha auditoria não presume que um canal atualiza os demais: compara a informação em cada ponto e registra a defasagem.
O satélite de auditoria técnica para citação por IAs aplica esse raciocínio à triagem por URL e mecanismo. Aqui, o foco é o modelo de operação entre as camadas e os responsáveis por mantê-las alinhadas.
Governança de Rastreamento, Descoberta e Controles de Acesso
Organize descoberta e acesso para que as páginas prioritárias tenham caminhos rastreáveis e para que os controles de cada fornecedor reflitam a política da empresa. Não existe uma regra única de robots.txt que resolva rastreamento, treinamento, busca e requisições iniciadas por usuários em todas as plataformas.
No Google, os recursos generativos usam fundamentos da Busca e dependem de páginas que possam ser rastreadas e indexadas. A orientação oficial destaca rastreabilidade, acesso permitido pela infraestrutura e links internos como práticas importantes, mas não como garantia de exibição.
A documentação da OpenAI mostra por que a governança precisa ser específica. Ela distingue OAI-SearchBot para recursos de busca, GPTBot para rastreamento associado a possível uso em treinamento e ChatGPT-User para algumas requisições iniciadas por usuários. Esses controles são independentes, portanto a equipe precisa escolher a política por finalidade.
| Componente | Função no fluxo | Controle operacional |
|---|---|---|
| Links internos | Conduzem pessoas e mecanismos às páginas relevantes | Usar elementos rastreáveis e evitar páginas importantes órfãs |
| Sitemap | Informa um conjunto de URLs que a equipe considera importantes | Manter apenas URLs válidas, canônicas e atualizadas |
| robots.txt | Comunica preferências de rastreamento para agentes que o processam | Revisar grupos por user-agent e não confundir com controle de acesso |
| CDN ou WAF | Protege a infraestrutura e pode filtrar requisições | Identificar bloqueios por regras, frequência, região ou desafio |
| Autenticação | Restringe conteúdo a usuários autorizados | Confirmar se a página pública não depende de uma sessão para mostrar conteúdo essencial |
| Logs | Registram requisições que chegaram à infraestrutura | Correlacionar horário, agente, IP, URL, status e motivo de bloqueio |
Eu mantenho uma matriz de agentes com finalidade, user-agent, IP publicado quando aplicável, diretiva pretendida, regra de firewall e responsável pela revisão. Para Perplexity e Claude, a equipe deve validar as instruções atuais de cada fornecedor, sem copiar a configuração do Google ou da OpenAI como se os agentes fossem intercambiáveis.
o guia sobre rastreadores de IA no robots.txt aprofunda a distinção entre acesso de busca, rastreamento para outros usos e requisições iniciadas pelo usuário, além de mostrar como revisar logs e controles por agente.
Legibilidade de Conteúdo e Paridade na Renderização JavaScript
Torne o conteúdo principal acessível em texto, com links e hierarquia coerentes, e teste o que é entregue antes e depois da renderização. A página deve comunicar a mesma informação essencial a quem navega e aos sistemas que processam seus recursos públicos.
Eu não trato HTML semântico perfeito ou um formato de conteúdo específico como requisito universal para recursos generativos. A documentação atual do Google recomenda uma estrutura técnica clara e texto disponível, orienta seguir práticas usuais de SEO para JavaScript e afirma que não é necessário dividir páginas em pequenos fragmentos para ajudar seus sistemas.
Em projetos com renderização no cliente, eu comparo o HTML inicial com o DOM final e verifico se título, texto principal, links, canonical e marcação estão presentes e coerentes. Quando o conteúdo essencial só aparece após autenticação, clique, carregamento externo ou interação que não ocorre no contexto de acesso do agente, registro a dependência e proponho uma alternativa técnica apropriada.
| Elemento | Sinal de consistência | Sinal de risco |
|---|---|---|
| Título e H1 | Descrevem o mesmo assunto e entidade | Título genérico ou alterado por script sem correspondência |
| Conteúdo principal | Texto completo e visível no estado público | Placeholder, conteúdo vazio ou dependente de sessão |
| Links | Destinos reais em href | Navegação que existe apenas como evento sem URL acessível |
| Canonical | URL preferencial estável e alinhada aos links internos | Canonical muda após renderização ou aponta para outra intenção |
| Imagens e mídia | Têm contexto textual e carregam sem bloqueio | Informação exclusiva em imagem sem descrição ou mídia indisponível |
| Dados estruturados | Descrevem entidades e propriedades presentes na página | JSON-LD divergente do texto, da interface ou da oferta atual |
Essa checagem não exige reescrever cada artigo em um formato rígido para IAs. Uma tabela, uma imagem ou uma resposta direta devem existir porque ajudam o usuário a compreender ou executar uma tarefa, não porque se presume que o sistema prefira aquele formato.
O conteúdo já publicado sobre Arquitetura de Conteúdo para AI Overview aprofunda estrutura editorial e respostas para a Busca do Google. O artigo sobre micro-silos de GEO complementa o trabalho ao decidir quais tarefas devem compartilhar uma página e quais justificam URLs próprias.
Qual é o papel de Schema.org e JSON-LD em GEO?
Schema.org e JSON-LD ajudam a expressar entidades e propriedades de forma estruturada, mas não substituem o conteúdo visível nem garantem que um mecanismo generativo selecione uma página. Eu os trato como uma camada de descrição e validação, não como um interruptor de citação.
Para o Google, dados estruturados continuam relevantes como parte de SEO e para a elegibilidade a certos resultados enriquecidos, mas não há um schema especial obrigatório para AI Overviews ou AI Mode. A orientação também recomenda que a marcação corresponda ao texto visível.
Na prática, o tipo e as propriedades devem acompanhar o objeto real. Uma organização pode ser descrita como Organization, um artigo editorial como Article, e uma oferta de produto como Product e Offer, desde que os dados existam e sejam sustentados pela página. Não adicione uma propriedade apenas porque ela aparece em um exemplo de código.
| Situação | Tipo de marcação que pode ser considerado | Verificação essencial |
|---|---|---|
| Identidade corporativa | Organization | Nome, domínio, logotipo e perfis correspondem à identidade apresentada |
| Conteúdo editorial | Article ou tipo mais específico adequado | Título, autor, data e imagem refletem a página publicada |
| Catálogo comercial | Product e Offer | Produto, preço, disponibilidade e condições batem com a oferta visível |
| Negócio local | Tipo apropriado de LocalBusiness | Endereço, horário e serviços correspondem às informações públicas |
| Conteúdo multimídia | Tipos apropriados para imagem ou vídeo | Mídia, descrição, duração ou transcrição são verificáveis quando aplicável |
O satélite de Schema.org, JSON-LD e renderização JavaScript mostrará como verificar paridade entre HTML inicial, DOM renderizado, texto visível e marcação. Ele aprofunda a implementação prática sem transformar dados estruturados em garantia de citação.
Sincronização entre Fonte de Verdade, Feeds, APIs e Catálogo
Mantenha uma fonte de verdade identificável e documente como os dados chegam a cada interface pública. Para preço, estoque, disponibilidade, especificação ou identidade, uma auditoria precisa acompanhar não só o conteúdo da página, mas também a atualização nos sistemas que a alimentam.
Eu construo um mapa de dependências entre sistema de origem, processo de publicação, API ou feed, template, HTML, JSON-LD e sitemap. Para cada dado crítico, registro proprietário, frequência de atualização, tolerância a defasagem e evidência que confirma a publicação correta.
| Dado | Fonte de verdade possível | Saídas que devem ser comparadas | Risco de divergência |
|---|---|---|---|
| Preço | Sistema comercial ou catálogo | HTML, JSON-LD, feed de produto e API | Oferta antiga ou condição incompleta |
| Estoque | Sistema de inventário | Página de produto, feed e interface de compra | Disponibilidade contraditória |
| Nome e identidade | Governança de marca | Organization, rodapé, páginas institucionais e perfis oficiais | Entidade ambígua ou nomes conflitantes |
| Data editorial | CMS ou fluxo editorial | Página, metadados, sitemap e marcação | Data de atualização sem alteração material |
| Especificação | PIM ou fonte técnica aprovada | Descrição, tabela, feed e marcação | Característica atribuída à versão errada |
Em e-commerce, a sincronização também envolve Merchant Center e detalhes de negócio quando são relevantes às experiências de busca do Google. O Google recomenda manter as informações comerciais atuais para que produto e serviço possam ser compreendidos nos resultados pertinentes.
o artigo sobre feeds, APIs e observabilidade em GEO aprofunda governança de frescor e consistência. Para aplicações comerciais e agentes de compra, o texto sobre Universal Commerce Protocol explica por que dados de catálogo e oferta precisam de contratos e estruturas confiáveis. O ebook SEO para E-commerce complementa a organização de categorias e produtos.
Observabilidade e Métricas por Camada da Infraestrutura
Meça as etapas técnicas com evidências diferentes e não use rastreamento como sinônimo de citação. Logs mostram requisições; Search Console mostra indicadores de busca do Google; testes documentados observam respostas em plataformas específicas; analytics acompanha sessões e resultados segundo a implementação do site.
A documentação do Google informa que o relatório de desempenho generativo do Search Console inclui impressões de AI Overviews e AI Mode e permite observar páginas, países, datas e dispositivos. O relatório foi disponibilizado mundialmente para sites em 31 de agosto de 2026, mas pode não aparecer para propriedades sem impressões suficientes ou excluídas desses recursos.
O relatório não representa citações em ChatGPT, Perplexity ou Claude. Para esses produtos, uma equipe pode manter uma amostra operacional de perguntas e registrar plataforma, idioma, país, data, resposta e fontes apresentadas. Eu trato os dados como observações delimitadas, não como painel oficial universal de rankings de IA.
| Camada medida | Fonte de observação | Métrica ou evidência | Limite de interpretação |
|---|---|---|---|
| Acesso técnico | Logs, CDN e WAF | Requisição, status, frequência e bloqueios | A requisição não comprova indexação ou citação |
| Google Search generativa | Relatório de desempenho do Search Console | Impressões de links em AI Overviews e AI Mode | Não cobre produtos generativos de outros fornecedores |
| Recuperação em outras plataformas | Testes reproduzíveis com perguntas definidas | URL citada, menção, precisão e contexto | Resultado varia por consulta, local, data e produto |
| Visita ao site | Analytics e logs de referência | Sessões, páginas de entrada e eventos | Nem toda exposição gera clique rastreável |
| Resultado comercial | CRM, e-commerce e atribuição | Lead, pedido, receita direta ou assistida | Correlação não prova causalidade da citação |
o artigo sobre como medir GEO sem métricas inventadas detalha as fontes de observação e seus limites. Para uma definição operacional de presença, consulte o artigo existente de Share of Model, lembrando que o denominador e a amostra precisam ser explicitados.
Roteiro de Implementação de Governança Técnica em 12 Passos
Implemente governança técnica de GEO associando cada etapa a um responsável, uma fonte de verdade, um teste e um registro de mudança. Um processo contínuo é mais confiável do que uma auditoria que termina em recomendações sem proprietário nem reteste.
- Escolha páginas e dados prioritários. Separe URLs que representam conteúdo editorial, catálogo, serviço local ou informação institucional.
- Desenhe a cadeia de publicação. Identifique sistemas de origem, integrações, templates, endpoints, feeds e marcações.
- Defina a política de acesso por mecanismo. Registre agente, finalidade, regra de robots.txt, CDN ou WAF e responsável pela aprovação.
- Teste descoberta e resposta. Confirme links internos, URL final, status HTTP e comportamento da infraestrutura.
- Compare HTML e renderização. Verifique texto principal, links, metadados, canonical e dependências de JavaScript.
- Valide dados estruturados. Confira sintaxe, entidade, propriedades e paridade com a informação visível.
- Defina requisitos de frescor. Registre fonte de verdade, frequência de atualização e tolerância a divergências.
- Configure observabilidade. Guarde logs, indicadores de Search Console e protocolos de observação por plataforma.
- Priorize pelo impacto e alcance. Corrija primeiro falhas que afetam modelos de página ou dados críticos para o negócio.
- Reteste depois de mudanças. Compare a mesma URL, agente, resposta e camada antes e depois da implementação.
- Revise a matriz de fornecedores. Atualize documentação, user-agents e intervalos publicados quando o fornecedor mudar as instruções.
- Conecte o achado à ação editorial. Se a infraestrutura está correta, investigue intenção, clareza, evidência e atualização sem continuar alterando configurações técnicas sem causa observada.
A biblioteca de Prompts para SEO pode ajudar a gerar perguntas para testar cobertura, mas não substitui um protocolo de medição nem confirma que uma plataforma citou determinada URL. Para a operação de conteúdo, o pilar de arquitetura de conteúdo para citação por IAs organiza intenção, resposta, evidência e descoberta; este pilar técnico conecta essa estratégia aos sistemas que publicam e expõem as informações.
Como priorizar GEO técnico sem perseguir atalhos?
Priorize falhas que impedem o acesso, tornam a informação inconsistente ou deixam a equipe incapaz de verificar o que foi publicado. Não comece por arquivos ou marcações que não resolvem um problema observado.
O Google orienta que não é necessário criar arquivos especiais como llms.txt, quebrar artigos em pequenos blocos ou adicionar schema exclusivo para recursos generativos da Busca. Também recomenda manter boas práticas de SEO, estrutura clara e conteúdo útil. Essa orientação é específica ao Google, então as políticas de outros fornecedores devem ser avaliadas separadamente.
Eu uso quatro níveis de prioridade: primeiro, bloqueios e erros de resposta; depois, conteúdo essencial ausente ou inacessível; em seguida, divergências entre fonte de verdade e página; por último, melhorias de observabilidade e manutenção. Essa ordem evita investir em um dado estruturado perfeito sobre uma oferta que já está errada no sistema de origem.
O guia geral de GEO e o conteúdo sobre Branding Semântico ajudam a conectar a infraestrutura com presença de marca e qualidade de informação. O técnico precisa sustentar a estratégia, não substituir conteúdo, autoridade ou a decisão de negócio.
Visão Executiva para Sustentar o Programa de GEO Técnico
O objetivo é reduzir falhas entre os sistemas que publicam informação e as experiências que tentam acessá-la, com evidências suficientes para diagnosticar cada camada. Uma implementação tecnicamente correta cria condições de acesso e interpretação, mas não obriga qualquer mecanismo a selecionar ou citar uma página.
Eu recomendo manter um mapa de dependências, uma matriz de acesso por fornecedor e um registro de consistência dos dados críticos. Quando uma citação não aparece, a equipe consegue separar o que foi testado do que continua desconhecido, em vez de alterar schema, conteúdo ou robots.txt sem hipótese verificável.
Se sua operação já tem dados de produto, conteúdo e identidade espalhados por vários sistemas, qual elo da cadeia é hoje mais difícil de manter coerente: a fonte de verdade, a renderização, os controles de acesso ou a medição?